Warum die Integrität eines Log-Journals beweisen?
In den meisten modernen Systemen ermöglicht das Führen eines Log-Journals, die ausgeführten Aktionen nachzuvollziehen und zu verstehen, was im Falle eines Vorfalls passiert ist. In der Cybersicherheit spricht man oft vonaudit trail.
Das Logging ist ein wesentlicher Baustein jedes Systems, das sensible Daten verarbeitet. Es dient gleichzeitig dazu, Vorfälle zu diagnostizieren, zu auditieren und darauf zu reagieren. Das Problem ist, dass nach der Datenbank das zweite Ziel eines Angreifers oft die Logs selbst sind: indem er sie verändert, kann er eine Kompromittierung verschleiern oder jeglichen Nachweis unbefugten Zugriffs löschen, was die Erkennung und Reaktion erheblich erschwert.
Wenn diese Protokolle geändert oder gelöscht werden können, wird die gesamte Vertrauenskette fragwürdig.
Manche Normen verlangen zudem, dass diese Logs unfälschbar.
Dies ist bei der NF525 (Zertifizierung von Kassensoftware) der Fall, aber auch bei der Norm
PCI-DSS (Zahlungssicherheit) oder auch des
HDS für Gesundheitsdaten-Hoster (angelehnt an die Norm
ISO 27001).
Selbst ausserhalb der regulatorischen Auflagen, in Bereichen wie Gesundheit oder Finanzen, ist die Fähigkeit, die Integrität der Logs zu gewährleisten, kein Luxus mehr, sondern eine Notwendigkeit.
Bei der Konzeption eines solchen Systems verdienen drei Aspekte besondere Aufmerksamkeit:
Die Integrationskomplexität auf Applikationsseite,
Die Kosten entstanden durch die Speicherung und die digitale Signatur,
Der operationelle Aufwand im Zusammenhang mit der Verwaltung und Überprüfung sicherer Logs.
In diesem Beitrag werden wir zwei Ansätze vergleichen, um dieses Ziel zu erreichen:
eine naive Implementierung basierend auf einer
blockchain (was eine einfache und effiziente Lösung ist, aber keine Log-Rotation ermöglicht),
eine effizientere und pragmatischere Version, aufgebaut um die
Merkle Trees*.
Wir gehen hier davon aus, dass unsere Logs die untenstehende einfache Struktur haben, diese kann aber je nach Bedarf erweitert werden (source, level, …).
type LogEntry struct {
	Message   string    `json:"message"`
	Timestamp time.Time `json:"timestamp"`
}
Naive Implementierung: eine Blockchain
Die Hash-Kette (fälschlicherweise oft als Blockchain bezeichnet), obwohl sie heute vor allem mit der Welt der Kryptowährungen verbunden ist, ist ein kryptografisches Konzept, das bis in die 80er Jahre zurückreicht, und dessen erster konkreter Anwendungsfall die Zeitstempelung digitaler Dokumente war, um deren Fälschung zu verhindern.
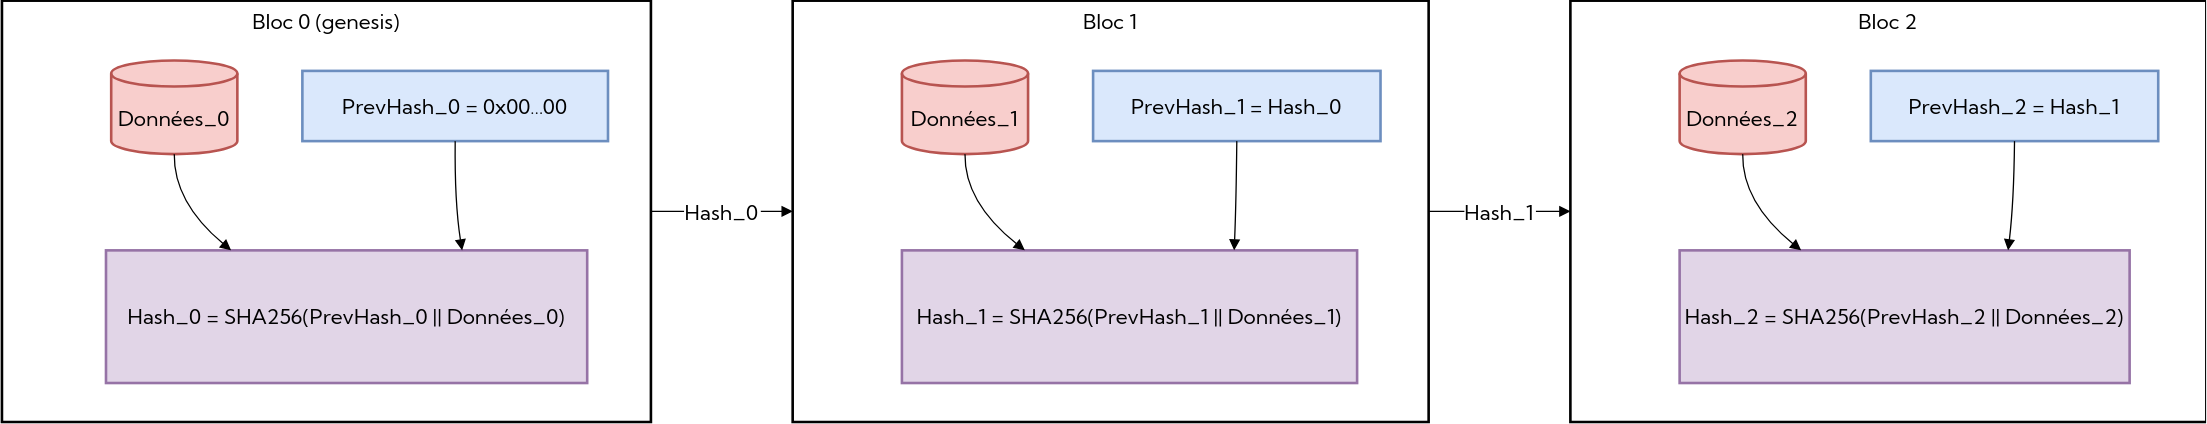
Eine Hash-Kette ist einfach eine Liste von Datenblöcken, wobei jeder Block durch die Verkettung der Prüfsumme des vorherigen Blocks und seiner eigenen Daten gehasht wird (z. B. SHA-256 oder BLAKE3).
Auf ein Log-Journal übertragen, bedeutet dies, pro Eintrag einen Block zu schmieden; sobald man bereinigen möchte, müsste man Millionen von Blöcken erneut abspielen oder neu signieren, was für ein einfaches Applikations-Journal unverhältnismässig ist.
Da der erste Block der Kette keinen Parent hat, ist er der einzige Vertrauenspunkt unseres Systems, deshalb wird er oft als “Block 0” oder “Genesis-Block” (genesis block im Englischen).
Implementierungsschema einer Hash-Kette
Obwohl dieses System in der Praxis konsistent ist, weist es in der Praxis mehrere Einschränkungen auf.
Ein Angreifer kann theoretisch die gesamte Kette neu berechnen wenn er Zugriff auf den Genesis-Block : es reicht, einen neuen Block 0 zu schmieden, alle Hashes neu zu berechnen und das Journal durch diese gefälschte Version zu ersetzen, die die lokale Überprüfung akzeptieren wird. Man reduziert dann lediglich das Risiko, eliminiert es aber nicht, solange der Ankerpunkt im selben Vertrauensbereich wie die Logs verbleibt. Erst durch Externalisierung oder kryptografische Signierung des Root-Elements (z. B. Signatur mit einem woanders gespeicherten Schlüssel oder periodische Veröffentlichung ausserhalb des IS) wird diese unerkennbare Neuberechnung unmöglich gemacht.
Die Überprüfung einer vollständigen Hash-Kette bleibt ebenfalls linear: jeder Block muss erneut abgespielt werden, um die Integrität des Ganzen zu bestätigen. Bei grossen Log-Mengen wird dies schnell ressourcenintensiv.
Ein weiteres Problem: die völlige Abwesenheit von Parallelisierung. Jeder Block hängt vom vorherigen ab, was das Neuberechnen oder Überprüfen mehrerer Teile der Kette parallel verhindert. Dies ist ein grosser Engpass für Anwendungen mit hohem Datenverkehr oder verteilte Architekturen.
Zudem ermöglicht eine Hash-Kette keine natürliche Log-Rotation : in einem Kontext der Aufbewahrung von mehreren Jahren (was im Rahmen mehrerer Normen eher üblich ist), muss die gesamte Historie gelöscht werden, und dann eine neue Kette von Grund auf neu aufgebaut werden, eine besonders aufwendige und wenig realistische Operation für Applikations-Journals.
Merkle-Baum: eine flexiblere Alternative
Ein flexiblerer Ansatz besteht darin, die Hash-Kette durch einen Merkle-Baum.
Verwendet im Dateisystem
ZFS um Datenverluste entgegenzuwirken in einem
RAID oder in Protokollen wie
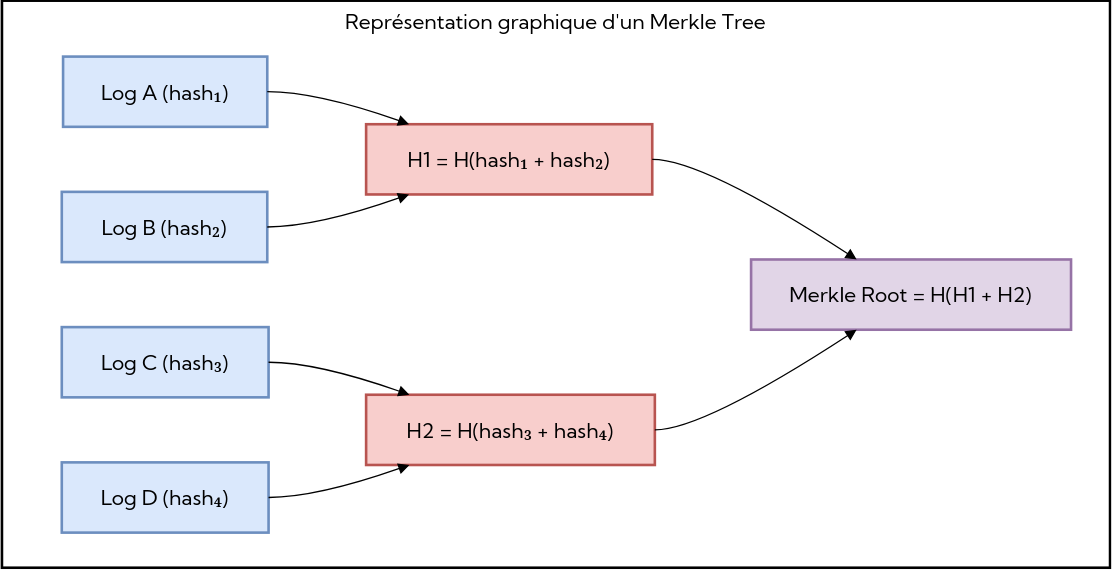
IPFS, das Konzept der Merkle-Bäume besteht darin, Logs in Form von Blättern in einem binären Baum zusammenzufassen. Jedes Blatt enthält den Hash des Logs, und jeder interne Knoten enthält den Hash der Verkettung seiner beiden Kinder. Die Spitze des Baumes, „Wurzel“ genannt, stellt eine kryptographische Zusage für die Gesamtheit der Logs dar.
Der Vorteil dieses Modells ist es, eine viel schnellere und teilweise Überprüfung zu ermöglichen. Um zu beweisen, dass ein bestimmtes Log tatsächlich zum Baum gehört, wird Folgendes bereitgestellt:
der Hash des Blattes (das Log selbst),
die geordnete Liste der Geschwister-Hashes, die beim Aufstieg zur Wurzel angetroffen werden, sowie ihre Links-/Rechts-Position.
Der Prüfer berechnet dann Schritt für Schritt neu, den Hash des Elternknotens aus dem aktuellen Hash und seinem Geschwister-Hash, und dann den des übergeordneten Levels, bis die Wurzel wiederhergestellt ist. Entspricht die erhaltene Wurzel der öffentlichen Wurzel, wird der Beweis akzeptiert; andernfalls schlägt er fehl. Dieser Beweis, genannt Merkle Proof (oder „Zugehörigkeitsbeweis“), wird mit logarithmischer Komplexität berechnet.
Dieser Ansatz korrigiert praktisch alle Nachteile einer Hash-Kette, wenn man von Log-Journalen spricht.
Es ist nicht mehr nötig, die gesamte Ereignissequenz erneut abzuspielen, um ein Log zu überprüfen, genügt ein Zugehörigkeitsbeweis, der nur aus den lateralen Hashes besteht.
Jeder Unterbaum kann unabhängig berechnet werden, dies ermöglicht die Verteilung der Berechnung auf mehrere Maschinen (oder Threads), was den einer Hash-Kette inhärenten Engpass beseitigt (wo jeder Block vom vorhergehenden abhängt).
Ein vollständiger Unterbaum kann abgeschnitten oder archiviert werden, ohne die Gültigkeit des Rests zu beeinträchtigen: Man trennt die Verbindung zum veralteten Teil, berechnet die Hashes bis zum Schnittknoten neu und betrachtet diesen Knoten als neue Wurzel für das aktuelle Fenster. Es ist nicht nötig, alle beibehaltenen Blätter zu löschen oder neu abzuspielen.
Jeder Service oder jede VM kann parallel seinen eigenen Baum erstellen und seine Wurzel veröffentlichen, diese Wurzeln können dann in einem Baum von Wurzeln kombiniert werden, was das Modell horizontal perfekt skalierbar macht.
Proof of Concept
Dieser PoC setzt vier Ziele:
Die Wurzel im Streaming über einen StreamBuilder, mit O(log n) Speicher (es gibt also keinen vollständigen Baum im RAM).
Inklusionsbeweise generieren und überprüfen mit einem expliziten Baum, serialisierbar in SQLite für Audit und Wiederherstellung.
Die Äquivalenz Stream <=> Baum validieren, auch unter Konkurrenzbedingungen, mittels deterministischer Tests und Fuzzing.
Die Wurzeln (und Signaturen) regelmässig in unveränderlichem Speicher vom Typ S3 Object Lock / Äquivalent veröffentlichen, um Checkpoints zu datieren und zu sperren.
Um die Theorie zu überprüfen, haben wir einen PoC in Go implementiert (welches native Fuzzing-Tools für die Go-Toolchain bietet), der aus einigen einfachen Go-Modulen besteht: einer Struct LogEntry, Digests mit Domänentrennung, einen StreamBuilder mit O(log n) Speicher, einen expliziten Baum zur Beweisgenerierung und eine SQLite-Persistenz für das Audit.
const (
  leafPrefix     byte = 0x00
  internalPrefix byte = 0x01
)

func LeafDigest(e LogEntry) [32]byte {
  m := e.Serialize()
  b := make([]byte, 1+len(m))
  b[0] = leafPrefix
  copy(b[1:], m)
  return sha256.Sum256(b)
}

func CombineDigests(l, r [32]byte) [32]byte {
  var buf [1 + 32 + 32]byte
  buf[0] = internalPrefix
  copy(buf[1:33], l[:])
  copy(buf[33:], r[:])
  return sha256.Sum256(buf[:])
}
Das Präfix 0x00 für die Blätter und 0x01 für interne Knoten verhindert jede strukturelle Kollision (eine Nachricht kann keinem Knoten „ähnlich sein“).
Expliziter Baum und Beweise
Node trägt entweder ein Blatt (Data), oder Zeiger Left/Right und einen zwischengespeicherten Hash.
BuildMerkleRoot faltet jede Ebene bis zur Wurzel.
GenerateProof steigt vom Blatt zur Wurzel auf, indem es die Geschwister-Hashes und deren Links-/Rechts-Position sammelt.
VerifyProof geht den Weg erneut und vergleicht ihn mit der erwarteten Wurzel.
type ProofStep struct{ Hash [32]byte; Right bool }

func VerifyProof(leaf LogEntry, proof []ProofStep, root [32]byte) bool {
  h := LeafDigest(leaf)
  for _, s := range proof {
    if s.Right { h = CombineDigests(h, s.Hash) } else { h = CombineDigests(s.Hash, h) }
  }
  return h == root
}
Streaming in O(log n)
StreamBuilder akkumuliert einen Hash „pro Ebene“ (Binärzähler) und behält nur einen Slot pro Baumhöhe.
type StreamBuilder struct {
  mu sync.Mutex
  levels []levelDigest
  entryCount int
}

func (s *StreamBuilder) AddEntry(e LogEntry) {
  d := LeafDigest(e)
  s.mu.Lock()
  s.foldDigestLocked(0, d)
  s.entryCount++
  s.mu.Unlock()
}

func (s *StreamBuilder) Root() ([32]byte, bool) {
  s.mu.Lock(); defer s.mu.Unlock()
  var out [32]byte; var ok bool
  for _, slot := range s.levels {
    if !slot.filled { continue }
    if !ok { out, ok = slot.hash, true; continue }
    out = CombineDigests(slot.hash, out)
  }
  return out, ok
}
Man erhält dieselbe Wurzel wie mit einem vollständigen Baum, aber ohne den Baum zu speichern.
Persistenz und Audit
Der Baum kann anschliessend in einer Datenbank gespeichert werden, indem die Blätter (Payload + Hash) sowie die internen Knoten (Ebene, Position, Hash) eingefügt werden, was Folgendes ermöglicht:
den Baum wieder abzuspielen / Beweise lokal zu überprüfen
die Originalblätter für ein N-Tages-Fenster rückwirkend zu exportieren
die Struktur durch Sortieren nach Level / Position zu inspizieren.
Tests, Robustheit und Fuzzing
Das Ziel der Tests ist zweifach: die kryptographischen Invarianten (Domänentrennung, Links-/Rechts-Reihenfolge, Stabilität) zu sperren und sicherzustellen, dass der Streaming-Pfad in O(log n) genau dieselbe Wurzel und dieselben Beweise wie ein expliziter Baum produziert, auch in einer parallelen Umgebung, in der mehrere Goroutinen den Zustand gleichzeitig speisen und lesen.
Hash- und Ordnungsinvarianten
Effektive Domänentrennung: Ein Blatt-Hash darf niemals einem internen Hash mit demselben Payload gleichen (Präfixe 0x00 / 0x01).
Nicht-Kommutativität: Das Vertauschen von Links/Rechts muss einen anderen Digest ergeben, was ein Neuanordnen der Kinder ohne Warnung verhindert.
Stabilität: Bei identischer Eingabe ist der Digest stabil (kein versteckter Zustand noch eine Zufallsquelle).
Baum, Beweise und Negative
Ein Zugehörigkeitsbeweis für ein echtes Blatt ist gültig, indem er bis zur erwarteten Wurzel neu zusammengesetzt wird. Negative Änderungen schlagen fehl (derselbe Beweis, aber modifizierter Payload, oder derselbe Payload mit Permutation eines Geschwister-Hashes).
Ein korrekter Beweis, der auf eine andere Wurzel angewendet wird, muss ebenfalls fehlschlagen, was vor Ausser-Fenster-Neulesungen schützt.
Gleichzeitigkeit
Mehrere goroutines erstellen jeweils einen Stream auf demselben Satz von Eingaben und vergleichen sie mit dem Referenz-Root (getestet mit -race).
Die gleichzeitige Generierung und Verifikation von Proofs auf einem geteilten Baum validiert das thread-safe Lesen und die Reinheit der Funktionen auf den Hashes. Bei der progressiven Verkettung werden Einträge hinzugefügt, während ein anderer Thread den Root liest, ohne beobachtbare Abweichung.
Fuzzing
Die Fuzzer generieren zufällige Log-Sequenzen, erstellen den Root, verifizieren einen Proof auf einem zufälligen Index und ändern dann die Payload oder die Reihenfolge der Geschwister, um sicherzustellen, dass der Proof fehlschlägt.
Die Parität zwischen StreamBuilder und BuildMerkleRoot wird bei ungeraden Grössen oder unvollständigen Ebenen geprüft, um denselben Root zu gewährleisten.
Begrenzte Fälle (Grösse 1, 2 und Zweierpotenzen) überprüfen die Verkettung der Slots und allfällige Duplikationen des letzten Blattes.
Die Fuzzing-Tests laufen kontinuierlich auf einer kleinen fuzzing farm von 56 vCPU während des Äquivalents von 176 Stunden CPU-Zeit (~3h Echtzeit) ohne False Negative, False Positive, Absturz oder Timeout, was eine gute Abdeckung der kritischen Pfade bietet.
Sobald der Merkle-Root berechnet ist, muss er irgendwo verankert werden, das heisst, ihn in einem Bereich zu veröffentlichen, wo er nicht mehr geändert werden kann.
Warum Checkpoints verankern?
Der Merkle-Tree gibt uns einen eindeutigen Root, der den genauen Zustand der Logs zu einem Zeitpunkt T darstellt.
Aber dieser Root bleibt ein einfacher Hash: wird er in einer klassischen Datenbank oder auf einer Festplatte gespeichert, verhindert nichts, ihn später neu zu schreiben.
Damit der Proof rechtlich und technisch gültig bleibt, muss jeder Root unveränderbar gemacht ab seiner Veröffentlichung.
man berechnet einen Root für einen bestimmten Zeitraum (z.B. ein Tag)
man veröffentlicht ihn in einem unveränderlichen Speicher
er wird nie wieder geändert
So muss ein Auditor, der einen Log von Tag -45 überprüft, nur den Proof mit dem Root des Checkpoints von Tag -45 vergleichen, um sicherzustellen, dass er zu diesem Datum bereits verankert war.
Wie oft soll der Root veröffentlicht werden?
Der Root muss den Zeitraum des zu überprüfenden Logs abdecken. Wenn Sie nur einen Root pro Tag um 23:59 Uhr veröffentlichen, kann ein Morgen-Log erst unveränderlich auditierbar nach der Veröffentlichung des Abend-Checkpoints sein. Hier sind zwei praktische Optionen:
Häufiger veröffentlichen (z.B. stündlich oder alle 10k Einträge). Die Kosten sind vernachlässigbar, da ein Checkpoint nur ein Hash + Signatur ist.
Einen fortlaufend generierten «Arbeits»-Root beibehalten (der StreamBuilder jederzeit den Root liefern kann) und ihn im Object Store verankern, sobald ein Audit angefordert wird. Dieser sofortige Root wird dann zum Referenzpunkt für diesen Log.
S3 Object Lock: auf Speicherebene garantierte Unveränderbarkeit
Bei AWS ist S3 Object Lock die einfachste Lösung, um diese Unveränderbarkeit zu erzielen.
Sie ermöglicht die Speicherung eines Objekts (hier eine JSON-Datei / ein Blob, der den Root + eine Signatur enthält
ED25519) mit zwei Garantien:
Das Objekt kann weder geändert noch gelöscht werden, solange der Aufbewahrungszeitraum nicht abgelaufen ist (Write Once Read Many)
Jeder Ersetzungsversuch erstellt eine neue Version; man kann auch einen legal hold anwenden, um die administrative Löschung zu blockieren.
In der Praxis bedeutet dies, dass ein einfacher Upload ausreicht, um den Checkpoint unveränderlich zu machen bis zum gewählten Aufbewahrungszeitraum.
aws s3api put-object \
  --bucket merkle-checkpoints \
  --key roots/2025-10-01.json \
  --object-lock-mode COMPLIANCE \
  --object-lock-retain-until-date 2025-12-31T00:00:00Z \
  --body checkpoint.json
Beispiel für Object Locking mit dem AWS CLI
Die Anwendung verwaltet die Unveränderbarkeit nicht mehr, sie wird an den Cloud-Anbieter delegiert (hier AWS).
Alternativen bei anderen Anbietern
Azure Blob Storage : bietet immutable blob policies und legal holds, mit ähnlichen Mechanismen (Aufbewahrungsdauer oder rechtlicher Sperre).
Google Cloud Storage : bietet die Object Retention Policies und Bucket Lock, die Objekte für vordefinierte Zeiträume sperren.
MinIO : im Self-Hosting, implementiert auch Object Lock, kompatibel mit der S3 API (zuverlässig unter der Bedingung einer Zero-Trust-Infrastruktur).
Warum dieser Ansatz ideal ist
Sie erfüllt direkt die Aufbewahrungsanforderungen von Normen wie NF525, PCI-DSS oder HDS : der Checkpoint befindet sich im Write Once, Read Many (WORM)-Modus. Wenn Roh-Logs anderswo gelöscht würden, würde der Inklusionsbeweis fehlschlagen, wodurch die Löschung erkennbar wird; zur Prävention werden die Logs auch in einem Bucket mit Aufbewahrung/Object Lock gespeichert.
Jeder Checkpoint ist ein Objekt von wenigen Bytes, das nur einmal gespeichert wird, weshalb die Kosten im Vergleich zum Volumen der Logs selbst vernachlässigbar sind.
Eine Wurzel pro Tag / Woche genügt; sie können repliziert und signiert werden, um die Nachvollziehbarkeit zu verstärken.
Kostenoptimierung und operationelles Design
Das Ziel ist nicht nur, konform zu sein, sondern auch in Bezug auf Speicherung und Berechnungen effizient zu bleiben.
Speicherung
Das Log-Volumen wächst oft sehr schnell; eine bewährte Methode ist es, die Merkle-Proofs von den Logs zu trennen:
Compute
Dank der Merkle-Struktur ist die Überprüfung eines gegebenen Logs logarithmisch. Selbst wenn der vollständige Verlauf mehrere Millionen Ereignisse enthält, ist die Gesamtheit niemals erforderlich, was Einsparungen bei Egress ermöglicht.
Fazit
Dieser Proof of Concept zeigt, dass es möglich ist, die Integrität eines Logbuchs ohne Hash-Kette, ohne spezialisierte Datenbank und ohne komplexe Infrastruktur zu gewährleisten.
Durch die Kombination einfacher Primitive (SHA-256 / BLAKE3, Merkle tree, unveränderlicher Speicherung) und Cloud-nativer Mechanismen wie S3 Object Lock, erhält man ein System, das überprüfbar, sparsam und konform mit den modernen Anforderungen an die Nachvollziehbarkeit ist.
Diese Lösung ersetzt nicht die Governance oder die Anwendungsüberwachung, sondern ist eine solide kryptografische Basis, auf der ein dauerhafter und transparenter Audit trail aufgebaut werden kann.