Perché dimostrare l'integrità di un registro di log?
Nella maggior parte dei sistemi moderni, mantenere un registro di logs permette di tracciare le azioni eseguite e di capire cosa è successo in caso di incidente. Nella cybersicurezza, si parla spesso diaudit trail.
Il logging è un elemento essenziale di qualsiasi sistema che manipola dati sensibili. Serve sia a diagnosticare, auditare e rispondere agli incidenti. Il problema è che dopo il database, il secondo obiettivo di un attaccante sono spesso i logs stessi: alterandoli, può nascondere una compromissione o cancellare qualsiasi prova di accesso non autorizzato, il che rende la rilevazione e la risposta molto più difficili.
Se questi registri possono essere modificati o eliminati, allora l'intera catena di fiducia diventa discutibile.
Alcune norme richiedono inoltre che questi logs siano infalsificabili.
È il caso della NF525 (certificazione dei software di cassa), ma anche della norma
PCI-DSS (sicurezza dei pagamenti) o anche del
HDS per gli hoster di dati sanitari (basato sulla norma
ISO 27001).
Anche al di fuori dei vincoli normativi, in settori come la sanità o la finanza, la capacità di garantire l'integrità dei logs non è più un lusso ma una necessità.
Quando si progetta un sistema del genere, tre aspetti meritano un'attenzione particolare:
La complessità di integrazione lato applicativo,
I costi indotti dall'archiviazione e dalla firma digitale,
Il carico operativo legato alla gestione e alla verifica dei logs sicuri.
In questo post, confronteremo due approcci per raggiungere questo obiettivo:
un'implementazione ingenua basata su una
blockchain (che è una soluzione semplice ed efficace, ma che non permette la rotazione dei logs),
una versione più efficace e pragmatica costruita attorno ai
Merkle Trees*.
Considereremo qui che i nostri logs abbiano la semplice struttura sottostante, ma può essere estesa secondo le esigenze (source, level, …).
type LogEntry struct {
	Message   string    `json:"message"`
	Timestamp time.Time `json:"timestamp"`
}
Implementazione naive: una blockchain
La catena di hash (chiamata blockchain per abuso di linguaggio), sebbene legata soprattutto all'universo delle criptovalute oggi, è un concetto crittografico che risale agli anni '80, e il cui primo caso d'uso concreto era la marcatura temporale di documenti digitali per impedirne la falsificazione.
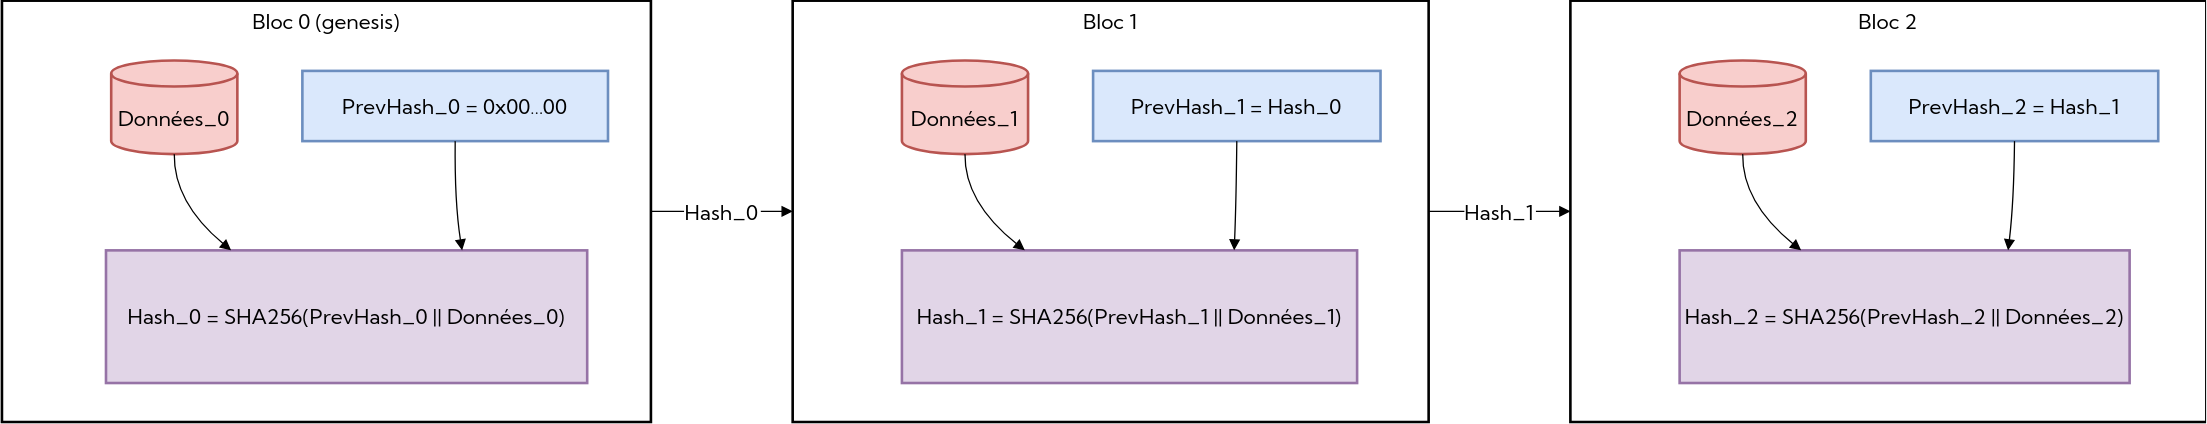
Una catena di hash è semplicemente un elenco di blocchi di dati, dove ogni blocco viene hashato sulla concatenazione del checksum del blocco precedente e dei propri dati (SHA-256 o BLAKE3 per esempio).
Trasposta a un registro di logs, ciò equivale a forgiare un blocco per voce; non appena si vuole purgare, bisognerebbe riprodurre o ri-firmare milioni di blocchi, il che è sproporzionato per un semplice registro applicativo.
Dato che il primo blocco della catena non ha un genitore, è l'unico punto di fiducia del nostro sistema, per questo motivo è spesso chiamato “bloc 0” o “blocco genesi” (genesis block in inglese).
Schema di implementazione di una catena di hash
Sebbene in pratica questo sistema sia coerente, presenta diverse limitazioni nella pratica.
Un attaccante può, in teoria, ricalcolare l'intera catena se ha accesso al blocco genesi : basta forgiare un nuovo bloc 0, di riprodurre tutti gli hash e di sostituire il registro con questa versione falsificata, che la verifica locale accetterà. Si riduce così solo il rischio, non lo si elimina, finché il punto di ancoraggio rimane nello stesso perimetro di fiducia dei logs. Solo esternalizzando o firmando crittograficamente la radice (es. firma con una chiave memorizzata altrove o pubblicazione periodica fuori dal SI) si rende impossibile questo ricalcolo non rilevabile
La verifica di una catena di hash completa rimane anch'essa lineare: bisogna riprodurre ogni blocco per confermare l'integrità dell'insieme. Su grandi volumi di logs, ciò diventa rapidamente costoso in termini di risorse.
Altro problema: l'assenza totale di parallelizzazione. Ogni blocco dipende dal precedente, il che impedisce di ricalcolare o verificare più parti della catena in parallelo. È un bottleneck maggiore per le applicazioni ad alto traffico o le architetture distribuite.
Infine, una catena di hash non permette alcuna rotazione naturale dei logs : in un contesto di conservazione di diversi anni (il che è piuttosto comune nell'ambito di diverse norme), bisogna eliminare l'integralità della cronologia, e poi ricostruire una nuova catena da zero, un'operazione particolarmente pesante e poco realistica per i registri applicativi.
Albero di Merkle: un'alternativa più flessibile
Un approccio più flessibile consiste nel sostituire la catena di hash con un albero di Merkle.
Utilizzato nel sistema di file
ZFS per contrastare il degrado dei dati in un
RAID o in protocolli come
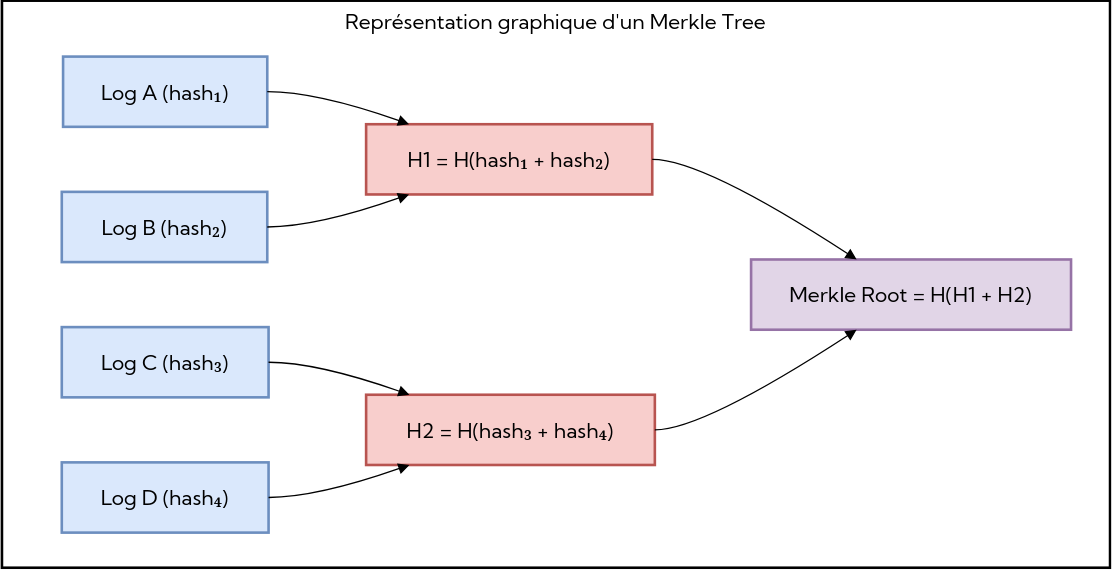
IPFS, il concetto degli alberi di Merkle è di raggruppare i log sotto forma di foglie in un albero binario. Ogni foglia contiene l'hash del log, e ogni nodo interno contiene l'hash della concatenazione dei suoi due figli. La cima dell'albero, chiamata “radice” rappresenta un impegno crittografico sull'insieme dei log.
L'interesse di questo modello è di permettere una verifica molto più rapida e parziale. Per provare che un dato log appartenga all'albero, si fornisce:
l'hash della foglia (il log stesso),
la lista ordinata degli hash fratelli incontrati risalendo verso la radice, così come la loro posizione sinistra/destra.
Il verificatore ricalcola quindi, passo dopo passo, l'hash del genitore a partire dall'hash corrente e di suo fratello, poi quello del livello superiore, fino a ricomporre la radice. Se la radice ottenuta corrisponde alla radice pubblica, la prova è accettata; altrimenti fallisce. Questa prova, chiamata Merkle Proof (o “prova di appartenenza”), si calcola in complessità logaritmica.
Questo approccio corregge praticamente tutti gli inconvenienti di una catena di hash quando si parla di registri di log.
Non è più necessario riprodurre l'intera sequenza di eventi, per verificare un log è sufficiente una prova di appartenenza, composta unicamente dagli hash laterali.
Ogni sotto-albero può essere calcolato indipendentemente, ciò permette di distribuire il calcolo su più macchine (o threads), eliminando il collo di bottiglia inerente alla catena di hash (dove ogni blocco dipende dal precedente).
Si può troncare o archiviare un sotto-albero completo senza rompere la validità del resto: si taglia il link verso la parte obsoleta, si ricalcolano gli hash fino al nodo di taglio e si considera questo nodo come nuova radice per la finestra corrente. Non c'è bisogno di eliminare né di riprodurre tutte le foglie conservate.
Ogni servizio o VM può costruire il proprio albero in parallelo e pubblicare la sua radice, queste radici possono poi essere combinate in un albero di radici, rendendo il modello perfettamente scalabile orizzontalmente.
Proof of concept
Questo PoC fissa quattro obiettivi:
Costruire e aggiornare la radice in streaming tramite un StreamBuilder, in O(log n) memoria (non c'è quindi un albero completo in RAM).
Generare e verificare prove di inclusione con un albero esplicito, serializzabile in SQLite per audit e ricostruzione.
Validare l'equivalenza stream <=> albero, anche in concorrenza, tramite test deterministici e fuzzing.
Pubblicare regolarmente le radici (e firme) in storage immutabile tipo S3 Object Lock / equivalente, per datare e bloccare i checkpoint.
Al fine di verificare la teoria, abbiamo implementato un PoC in Go (che offre strumenti di fuzzing nativi alla toolchain Go), che consiste in alcuni semplici moduli Go: una struct LogEntry, dei digest con separazione di dominio, un StreamBuilder in O(log n) memoria, un albero esplicito per la generazione di prove e una persistenza SQLite per l'audit.
const (
  leafPrefix     byte = 0x00
  internalPrefix byte = 0x01
)

func LeafDigest(e LogEntry) [32]byte {
  m := e.Serialize()
  b := make([]byte, 1+len(m))
  b[0] = leafPrefix
  copy(b[1:], m)
  return sha256.Sum256(b)
}

func CombineDigests(l, r [32]byte) [32]byte {
  var buf [1 + 32 + 32]byte
  buf[0] = internalPrefix
  copy(buf[1:33], l[:])
  copy(buf[33:], r[:])
  return sha256.Sum256(buf[:])
}
Il prefisso 0x00 per le foglie e 0x01 per i nodi interni evita qualsiasi collisione strutturale (un messaggio non può “assomigliare” a un nodo).
Albero esplicito e prove
Node contiene sia una foglia (Data), sia dei puntatori Left/Right e un hash memorizzato nella cache.
BuildMerkleRoot ripiega ogni livello fino alla radice.
GenerateProof risale dalla foglia alla radice raccogliendo gli hash fratelli e la loro posizione sinistra/destra.
VerifyProof rifà il percorso e confronta con la radice attesa.
type ProofStep struct{ Hash [32]byte; Right bool }

func VerifyProof(leaf LogEntry, proof []ProofStep, root [32]byte) bool {
  h := LeafDigest(leaf)
  for _, s := range proof {
    if s.Right { h = CombineDigests(h, s.Hash) } else { h = CombineDigests(s.Hash, h) }
  }
  return h == root
}
Streaming in O(log n)
StreamBuilder accumula un hash “per livello” (contatore binario) e conserva solo uno slot per altezza d'albero.
type StreamBuilder struct {
  mu sync.Mutex
  levels []levelDigest
  entryCount int
}

func (s *StreamBuilder) AddEntry(e LogEntry) {
  d := LeafDigest(e)
  s.mu.Lock()
  s.foldDigestLocked(0, d)
  s.entryCount++
  s.mu.Unlock()
}

func (s *StreamBuilder) Root() ([32]byte, bool) {
  s.mu.Lock(); defer s.mu.Unlock()
  var out [32]byte; var ok bool
  for _, slot := range s.levels {
    if !slot.filled { continue }
    if !ok { out, ok = slot.hash, true; continue }
    out = CombineDigests(slot.hash, out)
  }
  return out, ok
}
Si ottiene la stessa radice che con un albero completo, ma senza memorizzare l'albero.
Persistenza e audit
L'albero può poi essere memorizzato in un database inserendo le foglie (payload + hash) così come i nodi interni (livello, posizione, hash), il che permette:
di riprodurre l'albero / verificare prove localmente
di esportare le foglie originali per una finestra di N giorni indietro
di ispezionare la struttura ordinando per level / position.
Test, robustezza e fuzzing
L'obiettivo dei test è duplice: bloccare gli invarianti crittografici (separazione di dominio, ordine sinistra/destra, stabilità) e assicurare che il percorso streaming in O(log n) produca esattamente la stessa radice e le stesse prove di un albero esplicito, anche in ambiente concorrente dove diverse goroutine alimentano e leggono lo stato in parallelo.
Invarianti di hash e di ordine
Separazione di dominio effettiva: un hash di foglia non deve mai uguagliare un hash interno con lo stesso payload (prefissi 0x00 / 0x01).
Non-commutatività: invertire sinistra/destra deve dare un digest diverso, il che impedisce di riordinare i figli senza allertare.
Stabilità: a input identico, il digest è stabile (nessuno stato nascosto né sorgente di casualità).
Albero, prove e negativi
Una prova di appartenenza per una foglia reale è valida ricomponendo fino alla radice attesa. Le alterazioni negative falliscono (stessa prova ma payload modificato, o stesso payload con permutazione di un hash fratello).
Una prova corretta applicata a una radice diversa deve anch'essa fallire, il che protegge contro le riletture fuori finestra.
Concorrenza
Diverse goroutine costruiscono ciascuna uno stream sullo stesso lotto di input e confrontano con la radice di riferimento (testato con -race).
La generazione e successiva verifica simultanea di proofs su un albero condiviso valida la lettura thread-safe e la purezza delle funzioni sugli hash. In concatenazione progressiva, si aggiungono input mentre un altro thread legge la radice, senza divergenza osservabile.
Fuzzing
I fuzzers generano sequenze casuali di log, costruiscono la radice, verificano una prova su un indice casuale, poi alterano payload o ordine dei fratelli per assicurarsi che la prova fallisca.
La parità tra StreamBuilder e BuildMerkleRoot viene verificata su dimensioni dispari o livelli incompleti per garantire la stessa radice.
Casi limite (dimensione 1, 2 e potenze di due) verificano il concatenamento degli slot e le eventuali duplicazioni dell'ultima foglia.
I test di Fuzzing girano continuamente su una piccola fuzzing farm de 56 vCPU per l'equivalente di 176 ore di tempo CPU (~3h di tempo reale) senza falsi negativi, falsi positivi, crash né timeout, il che offre una buona copertura dei percorsi critici.
Una volta calcolata la radice Merkle, occorre ancorarla da qualche parte, cioè pubblicarla in uno spazio dove non potrà più essere modificata.
Perché ancorare i checkpoints?
Il Merkle tree ci fornisce una radice unica che rappresenta lo stato esatto dei log a un istante T.
Ma questa radice rimane un semplice hash: se è memorizzata in un database classico o su un disco, nulla impedisce di riscriverla in seguito.
Affinché la prova rimanga valida giuridicamente e tecnicamente, occorre che ogni radice sia immutabilizzata fin dalla sua pubblicazione.
Così, un revisore che verifica un log a G-45 deve solo confrontare la prova con la radice del checkpoint di G-45 per assicurarsi che fosse già ancorata a quella data.
Con quale frequenza pubblicare la radice?
La radice deve coprire il periodo del log da verificare. Se pubblichi solo una radice al giorno alle 23:59, un log del mattino non potrà essere auditabile in modo immutabile che dopo la pubblicazione del checkpoint serale. Ecco due opzioni in pratica:
Pubblicare più spesso (es. ogni ora, o ogni 10k input). Il costo è trascurabile poiché un checkpoint è solo un hash + firma.
Mantenere una radice "di lavoro" generata continuamente (il StreamBuilder sa dare la radice in ogni istante) e ancorarla nell'object store non appena viene richiesto un audit. Questa radice istantanea diventa quindi il punto di riferimento per questo log.
S3 Object Lock: immutabilità garantita a livello di storage
Su AWS, la soluzione più semplice per ottenere questa immutabilità è S3 Object Lock.
Permette di memorizzare un oggetto (qui un file JSON / un blob contenente la radice + una firma
ED25519) con due garanzie:
L'oggetto non può essere modificato né eliminato finché il periodo di ritenzione non è scaduto (Write Once Read Many)
Ogni tentativo di sostituzione crea una nuova versione; si può anche applicare un legal hold per bloccare l'eliminazione amministrativa.
In pratica, ciò significa che un semplice upload è sufficiente a rendere il checkpoint inalterabile fino al periodo di ritenzione scelto.
aws s3api put-object \
  --bucket merkle-checkpoints \
  --key roots/2025-10-01.json \
  --object-lock-mode COMPLIANCE \
  --object-lock-retain-until-date 2025-12-31T00:00:00Z \
  --body checkpoint.json
Esempio di object locking con la CLI AWS
L'applicazione non gestisce più l'immutabilità, è delegata al Cloud Provider (qui AWS).
Alternative presso altri fornitori
Azure Blob Storage : propone immutable blob policies e legal holds, con meccanismi simili (durata di ritenzione o blocco legale).
Google Cloud Storage : offre le Object Retention Policies e Bucket Lock, bloccando gli oggetti per durate predefinite.
MinIO : in self-hosted, implementa anche Object Lock, compatibile con l'API S3 (affidabile a condizione di avere un'infrastruttura zero trust).
Perché questo approccio è ideale
Risponde direttamente ai requisiti di ritenzione delle norme come NF525, PCI-DSS o HDS : il checkpoint è in modalità Write Once, Read Many (WORM). Se i log grezzi venissero eliminati altrove, la prova di inclusione fallirebbe, rendendo l'eliminazione rilevabile; per la prevenzione, si memorizzano anche i log in un bucket con ritenzione/Object Lock.
Ogni checkpoint è un oggetto di pochi byte archiviato una sola volta, quindi il costo è trascurabile rispetto al volume dei logs stessi.
Una radice al giorno / settimana è sufficiente; possono essere replicate e firmate per rafforzare la tracciabilità.
Ottimizzazione dei costi e design operativo
L'obiettivo non è solo essere conformi, ma rimanere efficienti in termini di archiviazione e calcoli.
Archiviazione
Il volume dei logs cresce spesso molto rapidamente, una buona pratica consiste nel dissociare le prove Merkle dai logs:
Elaborazione
Grazie alla struttura Merkle, la verifica di un dato log è logaritmica. Anche se la cronologia completa contiene milioni di eventi, l'intera cronologia non è mai necessaria, il che consente di risparmiare sull'egress.
Conclusione
Questo proof of concept mostra che è possibile garantire l'integrità di un registro di logs senza catena di hash, senza database specializzato e senza infrastruttura complessa.
Combinando primitive semplici (SHA-256 / BLAKE3, Merkle tree, archiviazione immutabile) e meccanismi cloud nativi come S3 Object Lock, si ottiene un sistema verificabile, frugale e conforme ai requisiti di tracciabilità moderni.
Questa soluzione non sostituisce la governance o la supervisione applicativa, ma è una solida base crittografica su cui costruire un audit trail duraturo e trasparente.