Während es relativ einfach ist, ein Audio von wenigen Minuten, in dem eine Person spricht, zu transkribieren, ist das Transkribieren von mehreren Stunden Gesprächen mit mehreren Beteiligten, mit Sprechüberlappungen und Fachbegriffen, eine weniger offensichtliche Aufgabe. Besonders wenn das Ziel anschliessend ist, ein Protokoll zuverlässiges zu erstellen, bei dem die Gesprächspartner kontinuierlich identifiziert werden müssen (die Erkennung der Gesprächspartner nennt man die Diarisierung).
In diesem Artikel werden wir sehen, warum klassische Transkriptionen ihre Grenzen haben und wie man verschiedene Ansätze kombiniert, um eine gleichzeitig kohärente, präzise und diarisierte Transkription zu erhalten.
Warum klassische Transkriptionen fehlschlagen können
Um das Problem der Transkription im Allgemeinen anzugehen, existieren zwei Modellfamilien:
Automatische Spracherkennung (ASR) kontinuierlich
Einerseits gibt es die kontinuierlichen ASR-Systeme (Automatic Speech Recognition), die nur auf einen lokalen Audiokontext für die Aufnahme zugreifen können und sich daher hauptsächlich auf phonetische / kurzfristige Aspekte stützen. Ihre Leistung bleibt bei zunehmender Aufnahmelänge stabil. Dies macht sie auch anfällig: Bestimmte phonetisch ähnliche Ausdrücke können ohne globale semantische Informationen schwer zu unterscheiden sein.
Diese Systeme können die Zeitlichkeit jedes Wortes präzise berücksichtigen, was die Synchronisierung des Textes mit dem Audio ermöglicht, aber vor allem deren Kopplung mit einem Modell für Diarisierung, das es ermöglicht, jede Sprechäusserung einem Sprecher zuzuordnen, auf lange Sicht kohärent. So kann jeder Sprechäusserung ein Zeitstempel (timestamp) und eine Identität zugewiesen werden.
Eine Stichwortliste kann gegebenenfalls bereitgestellt werden, um die Wahrscheinlichkeit bestimmter Wörter künstlich zu erhöhen, dies ermöglicht jedoch nur eine begrenzte Berücksichtigung des externen Kontexts zur Aufnahme.
Zusammenfassend: mittlere bis gute Leistung, aber unabhängig von der Länge der Eingabe, mit einer langfristig zuverlässigen Diarisierung.
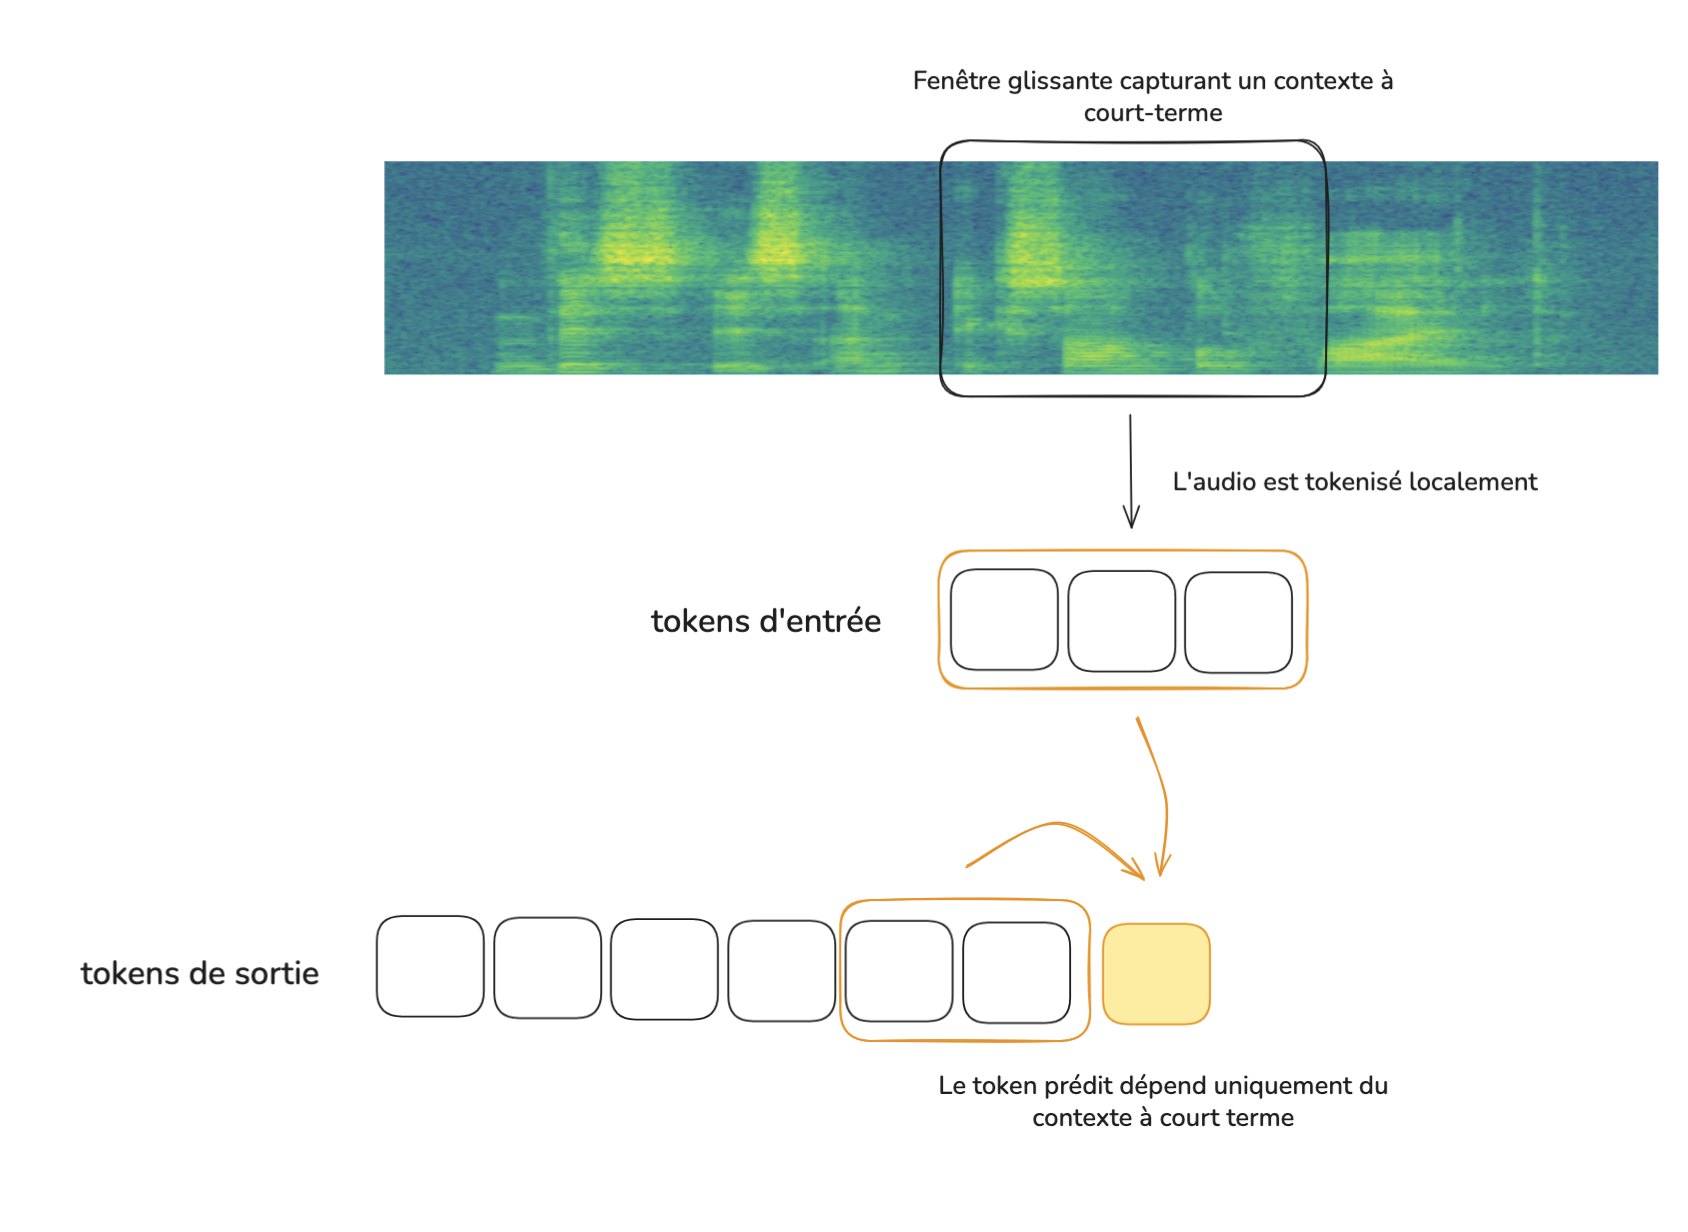
Vereinfachtes Schema eines kontinuierlichen ASR-Modells
Grosses multimodales Sprachmodell (MLLM)
Andererseits gibt es die multimodalen LLMs, die den gesamten Kontext berücksichtigen, um jedes Wort zu transkribieren und somit eine langfristige kontextuelle Kohärenz.
Ihre starke Leistung bei sprachbezogenen Aufgaben gewährleistet ein feines Verständnis der Aufnahme und vermeidet viele Missverständnisse. Sie können mit vollständigen Zusatzinformationen angereichert werden, aber auch eine präzise Diarisierung durchführen.
Dagegen verschlechtert sich ihre Leistung mit der Länge der Eingabe:
Wenn der Kontext zu reichhaltig wird, werden die Vorhersagen verrauscht.
Bestimmte präzise Informationen können verloren gehen, die Generierung verliert an Qualität.
Die Inferenzkosten steigen mit der Grösse der Eingabe.
Hier können Interventionen nicht präzise zeitlich gestempelt werden. Es ist möglich, timestamps anzufordern, aber diese werden sehr oft vom Modell halluziniert.
Kurz gesagt: exzellente Leistung bei moderaten Kontexten, die sich jedoch bei langen Aufnahmen verschlechtert und kostspielig wird.
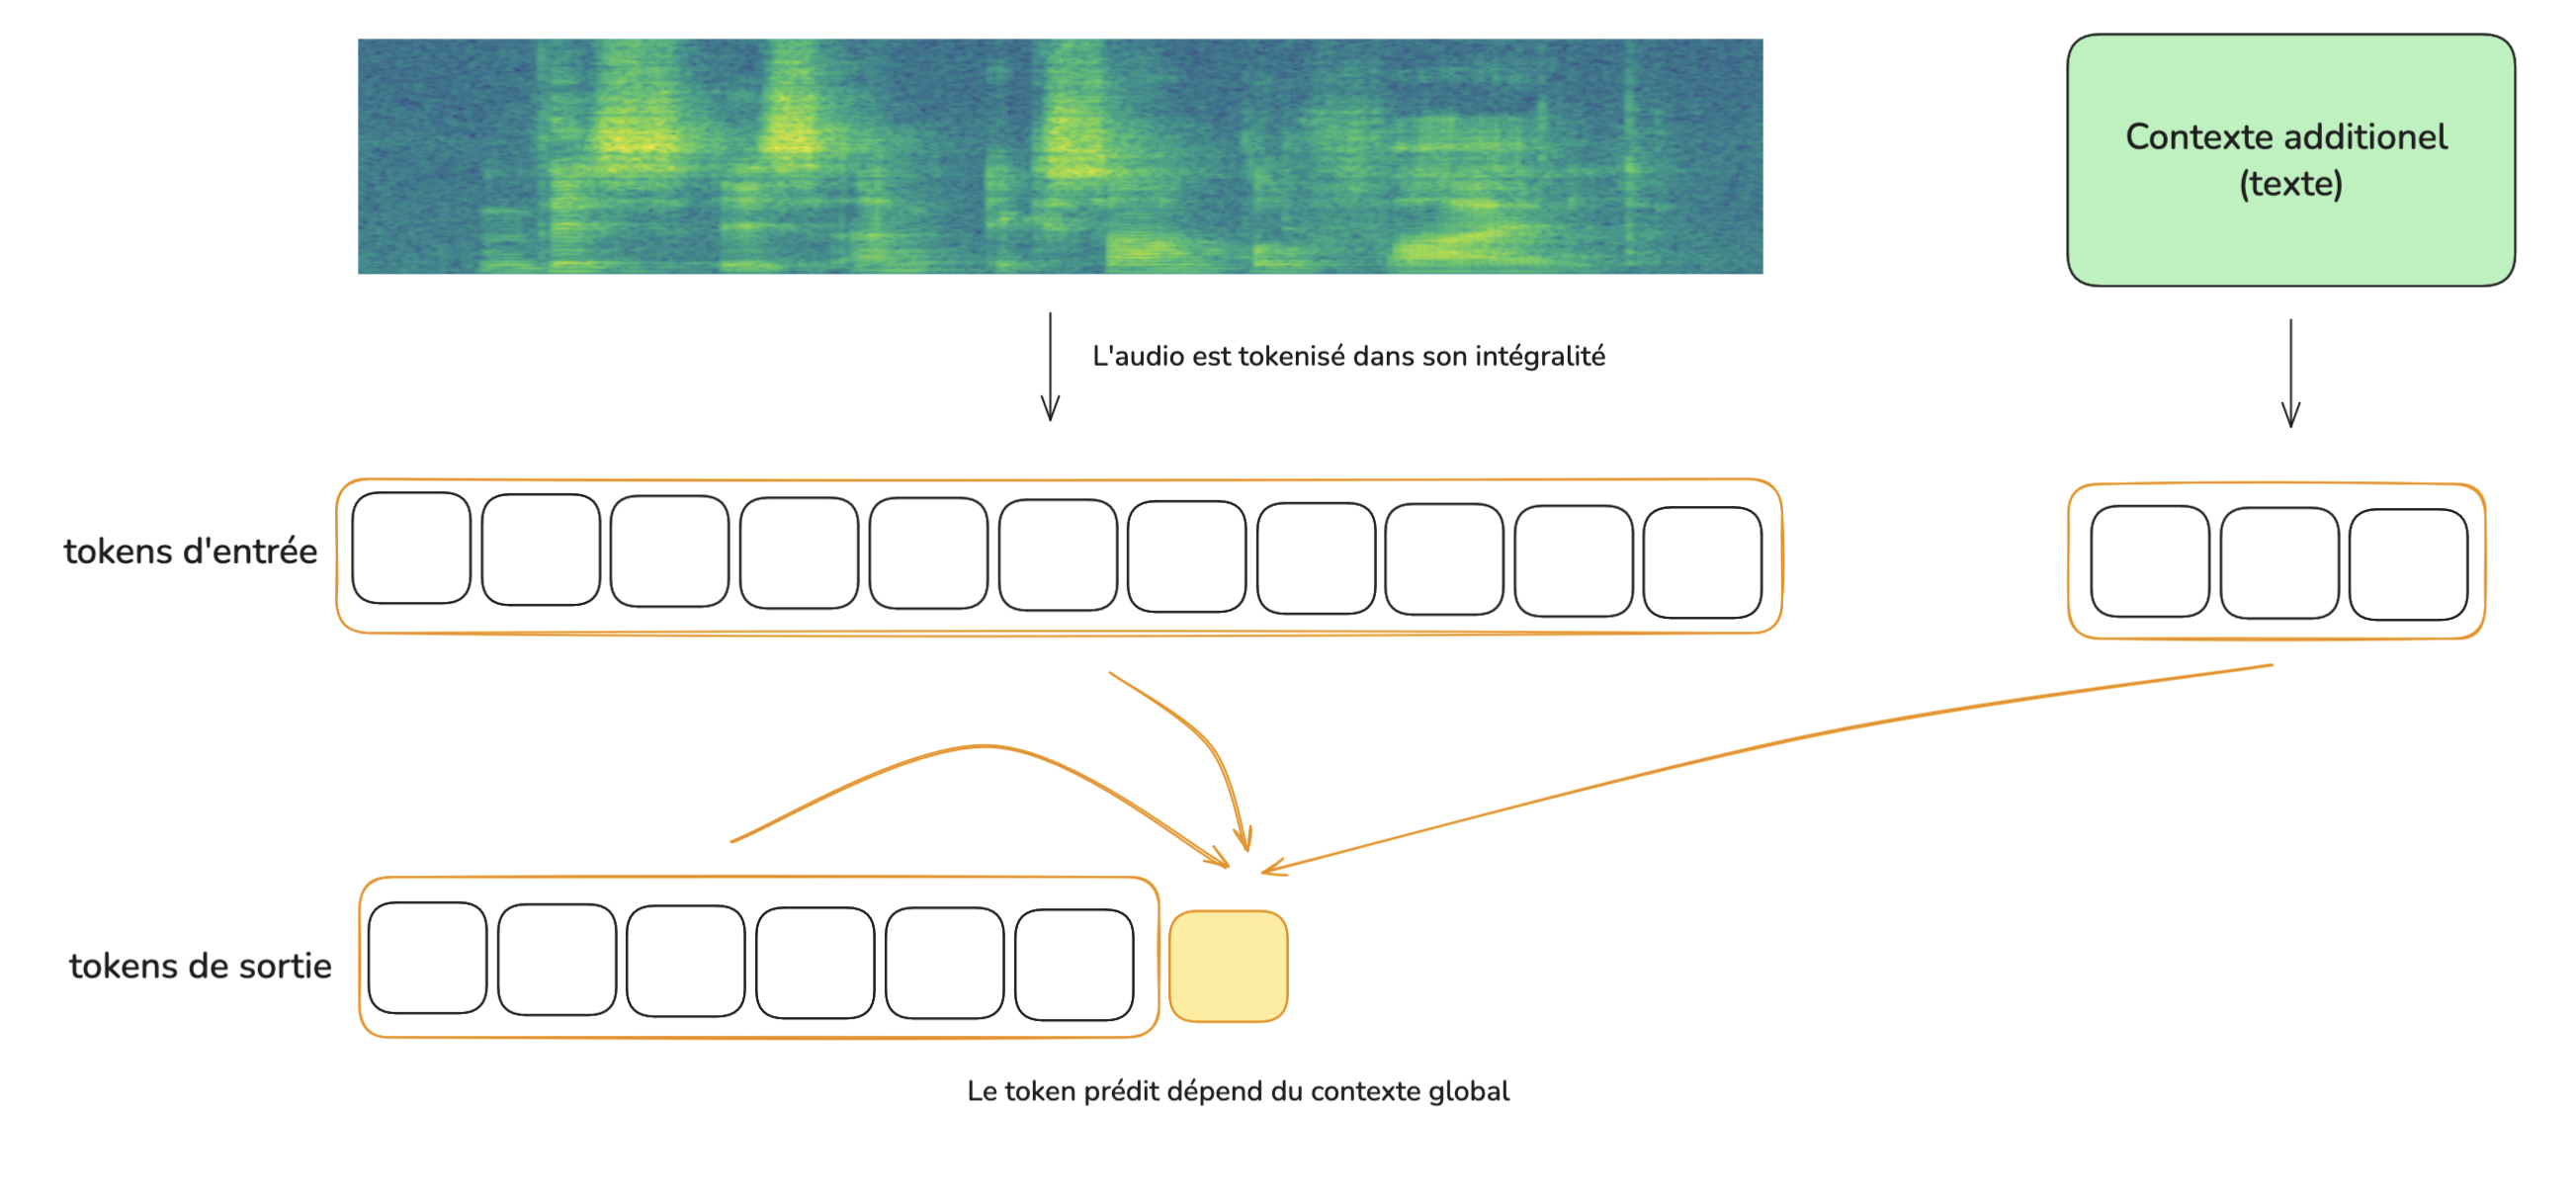
Vereinfachtes Schema eines MLLM im Rahmen einer Transkription
Es ist anzumerken, dass ASR-Systeme allein oft eine wesentlich bessere Latenz aufweisen als multimodale LLMs und daher oft besser für die Echtzeit-Transkription geeignet sind. In unserem Fall ist die Latenz kein Problem, daher wird dieses Kriterium nicht berücksichtigt.
Anstatt einen Kompromiss zwischen beiden zu finden, kann man beide Systeme gleichzeitig nutzen.
Schritt 1: Aufteilung in Chunks für das MLLM
Um eine optimale Leistung des MLLM zu gewährleisten, wird die Aufnahme in Chunks fester Grösse (z.B. 10-15 Minuten) aufgeteilt, mit Überlappung (overlap), jeder separat verarbeitet, wobei jedes Mal globale Kontextinformationen injiziert werden.
So kann das Modell reichhaltige Kontextinformationen nutzen, ohne dass die Länge der Eingabe seine Qualität beeinträchtigt. Es wird gebeten, eine recht freie, diarisierte Transkription zu liefern.
Grenze: Die Verfolgung der Sprecheridentitäten geht langfristig verloren, da die Chunks unabhängig voneinander verarbeitet werden: Es ist unmöglich zu wissen, ob Sprecher Nr. 2 des ersten Chunks derselbe ist wie Sprecher Nr. 2 des letzten Chunks.
Schritt 2: Vollständige Analyse über kontinuierliche ASR + Diarisierung
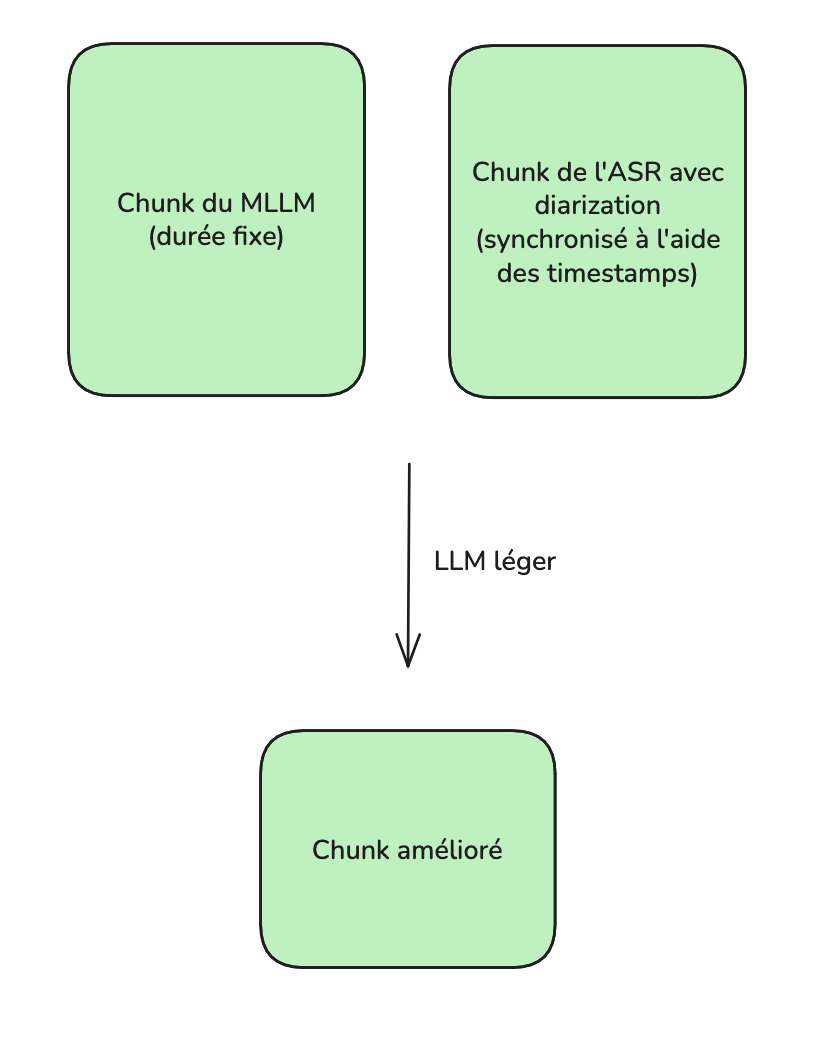
Für das kontinuierliche ASR-System mit Diarisierung kann das Audio in einem Durchgang analysiert werden. Das Ergebnis wird in Form von Segmenten vorliegen, die einem Gesprächspartner und einem Zeitindikator zugeordnet sind. Diese Timestamps ermöglichen es, das Ergebnis in Chunks zu unterteilen, die mit denen des MLLM synchronisiert sind.
Schritt 3: Chunk-für-Chunk-Fusion
Diese synchronisierten Chunks werden anschliessend fusioniert paarweise mit einem leichtgewichtigen und kostengünstigen LLM.
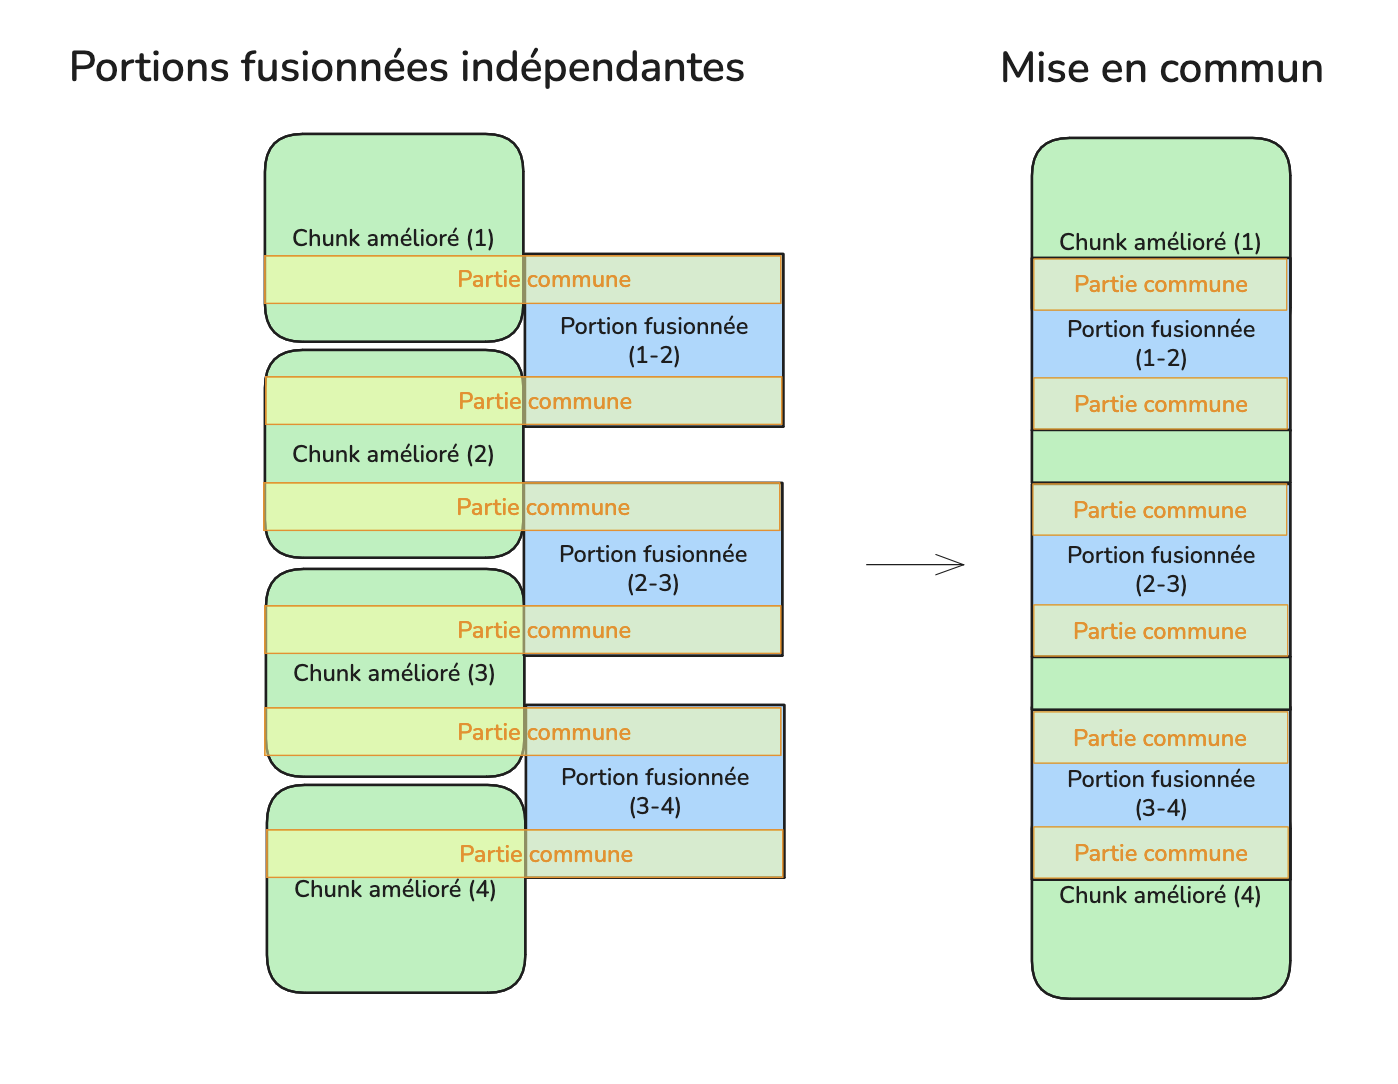
Fusion der Chunks, die einem gleichen Aufzeichnungsabschnitt entsprechen:
Schritt 4: Endgültige Fusion
Schliesslich werden all diese verbesserten Chunks fusioniert, um eine vereinheitlichte Transkription zu erstellen.
Ein leichtgewichtiges LLM wird erneut verwendet, um den Ressourcenverbrauch zu begrenzen.
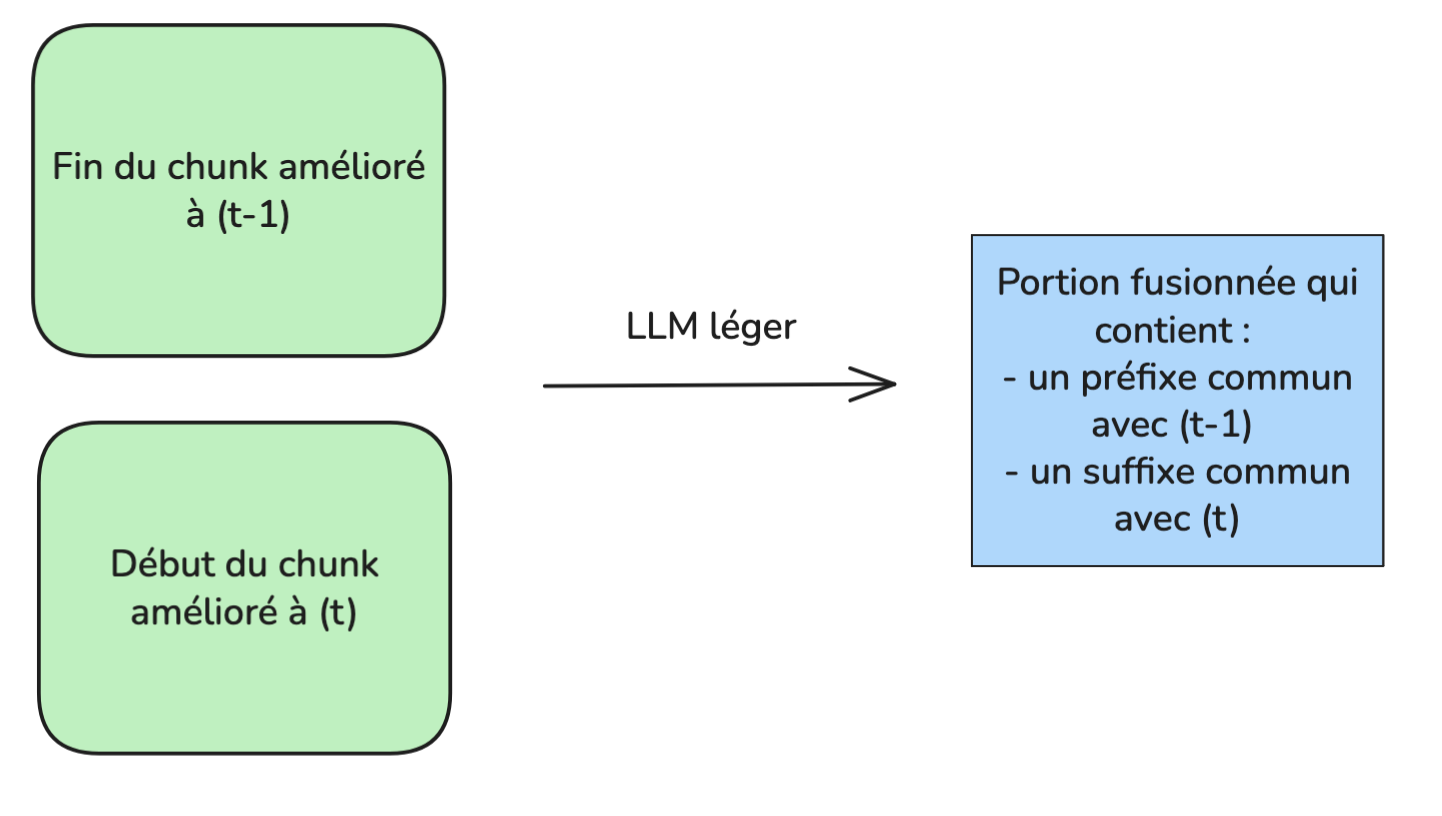
Angrenzende Chunks werden paarweise fusioniert, mit Überlappung, um Übergänge zu erleichtern.
Das Modell erhält die Anweisung, einen einzigen Text zu erstellen, der ein gemeinsames Präfix mit dem Anfang des vorhergehenden Kontextes, und ein gemeinsames Suffix mit dem Ende des folgenden Kontextes.
Die Überlappung zwischen den Chunks gewährleistet, dass im Prozess keine Informationen verloren gehen
Ergebnis: eine zuverlässige, kohärente und über die gesamte Dauer diarisierte Transkription.
Fusion von zwei aufeinanderfolgenden Chunks, um anschliessend alle Chunks einfach fusionieren zu können:
Fusion aller Chunks:
Kostenanalyse
Die Transkriptions- und Fusionsmethoden sind unabhängig von der Länge der Eingabe, sodass die Qualität konstant bleibt. Die Kosten sind zudem linear zur Länge der Eingabe, was das Verfahren für beliebig lange Aufnahmen praktikabel macht. Die Kosten des MLLM sind insgesamt dominant, der Rest macht etwa 30-50% zusätzlich aus. Aus wirtschaftlicher Sicht liegen die Kosten bei etwa 0.50€ - 1€ pro Stunde Audio.
Hinsichtlich des Ressourcenverbrauchs liegt man unter einem einzigen Aufruf eines MLLM (wie man es bei einem Chatbot tun könnte), wenn die Aufnahme mehrere Stunden dauert. Tatsächlich haben MLLMs (und LLMs im Allgemeinen) Kosten pro Token, die mit der Länge der Eingabe oder Ausgabe steigen. Durch die Beschränkung auf Chunks von 10-15 Minuten bleibt der Verbrauch pro Token moderat.
In der Praxis begrenzen einige Anbieter für den ASR + Diarisierungs-Teil die Verarbeitung auf 4–6 Stunden Audio, was eine Einschränkung sein kann. Ein analoges System kann manuell mithilfe der pyannote-Bibliothek und eines lokalen Modells konzipiert werden.
Metriken
Die verschiedenen Methoden wurden auf dem FLEURS fr Dataset (kurze Aufnahmen mit einem einzelnen Sprecher) verglichen, um den Qualitätstransfer vom MLLM zu unserem Ansatz hervorzuheben. Und auf dem SUMM-RE Dataset (Besprechungen mit mehreren Sprechern), wo die Fehleranzahl als LLM-as-a-judge gezählt wurde.
FLEURS - FR
| Modus | Raw WER |
|---|
| azure speech recognition (diarisiert) | 9.6% |
| gemini 3 flash | 3.1% |
| duale Transkription (unserer) | 3.1% |
SUMM-RE - DE
| Modus | semantische Diskrepanzen (geringfügig) | semantische Diskrepanzen (erheblich) | Genauigkeit der Sprecherzuweisung |
|---|
| azure speech recognition (diarisiert) | 12 | 2 | 86% |
| gemini 3 flash | 3 | 0 | |
| duale Transkription (unserer) | 2 | 0 | 88% |
Fazit
Die hier beschriebene Methode ermöglicht es, die Transkriptionsqualität, die bei kurzen Audios erreicht wird, auf beliebig lange Aufnahmen zu übertragen. Dies ist mit einer erheblichen Kostenerhöhung verbunden, die aber im Verhältnis zu den Gesamtkosten des Systems, bei dem die Transkription nur ein Schritt ist, relativiert werden muss. Dadurch werden viele Fehler vermieden, die beim Übergang von der Transkription zum abschliessenden Bericht unkorrigierbar wären.
Bewährte Praktiken
Einen overlap zwischen chunks, um die Zusammenführung zu erleichtern (ca. 30s - 1 Minute).
Ausreichend lange chunks verwenden, damit das MLLM von den Kontextinformationen profitiert, aber kurz genug, um seine Leistung nicht zu beeinträchtigen (10-20 Minuten ist ein guter Kompromiss).
Wenn möglich, die Temperatur im MLLM auf einen Wert nahe 0 einstellen, um das Rauschen zu begrenzen.
Ein einfacheres System als dieses wäre eine bessere Option, wenn das Ziel ist, kurze Audios zu transkribieren (einige Dutzend Minuten).