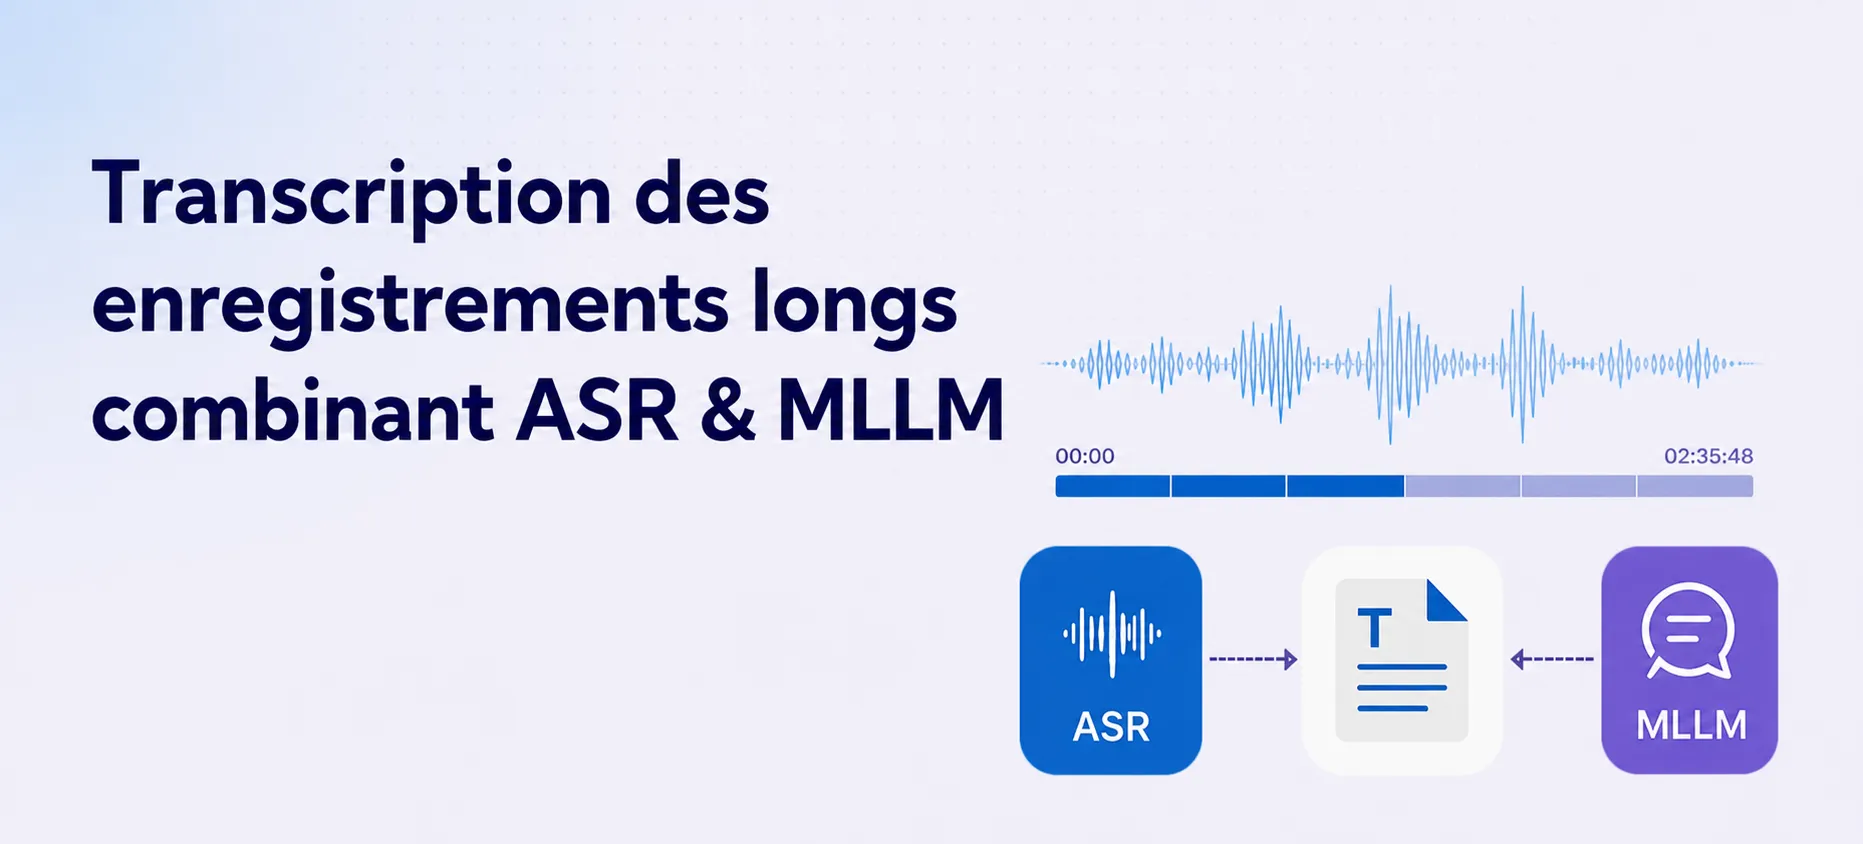
Se è relativamente semplice trascrivere un audio di pochi minuti in cui parla una persona, trascrivere diverse ore di scambi con più interlocutori, con sovrapposizioni di parlato e termini specifici del settore, è un compito meno ovvio. Soprattutto quando l'obiettivo è poi produrre un resoconto affidabile, in cui gli interlocutori devono essere identificati continuamente (il riconoscimento degli interlocutori si chiama la diarizzazione).
In questo articolo, vedremo perché le trascrizioni classiche hanno i loro limiti e come combinare diversi approcci per ottenere una trascrizione coerente, precisa e diarizzata.
Perché le trascrizioni classiche possono fallire
Per affrontare il problema della trascrizione in generale, esistono due famiglie di modelli:
Riconoscimento automatico del parlato (ASR) continuo
Da un lato, abbiamo i sistemi ASR (Automatic Speech Recognition) continui, che hanno accesso solo a un contesto audio locale per la registrazione, e si basano quindi principalmente su aspetti fonetici / a breve termine. Hanno prestazioni stabili con la lunghezza della registrazione. Questo li rende anche fallibili: alcune espressioni foneticamente simili possono essere difficili da distinguere senza informazioni semantiche globali.
Questi sistemi possono tenere conto in modo preciso della temporalità di ogni parola, il che permette di sincronizzare il testo con l'audio, ma soprattutto di accoppiarli con un modello di diarizzazione, che permette di attribuire ogni intervento a un oratore, in modo coerente su lunghe durate. Si può così attribuire una marca temporale (timestamp) e un'identità a ogni intervento.
Una lista di parole chiave può eventualmente essere fornita per aumentare artificialmente la probabilità di alcune parole, ma questo permette solo una considerazione limitata del contesto esterno alla registrazione.
In sintesi: prestazioni da medie a buone, ma indipendenti dalla lunghezza dell'input, con una diarizzazione affidabile a lungo termine.
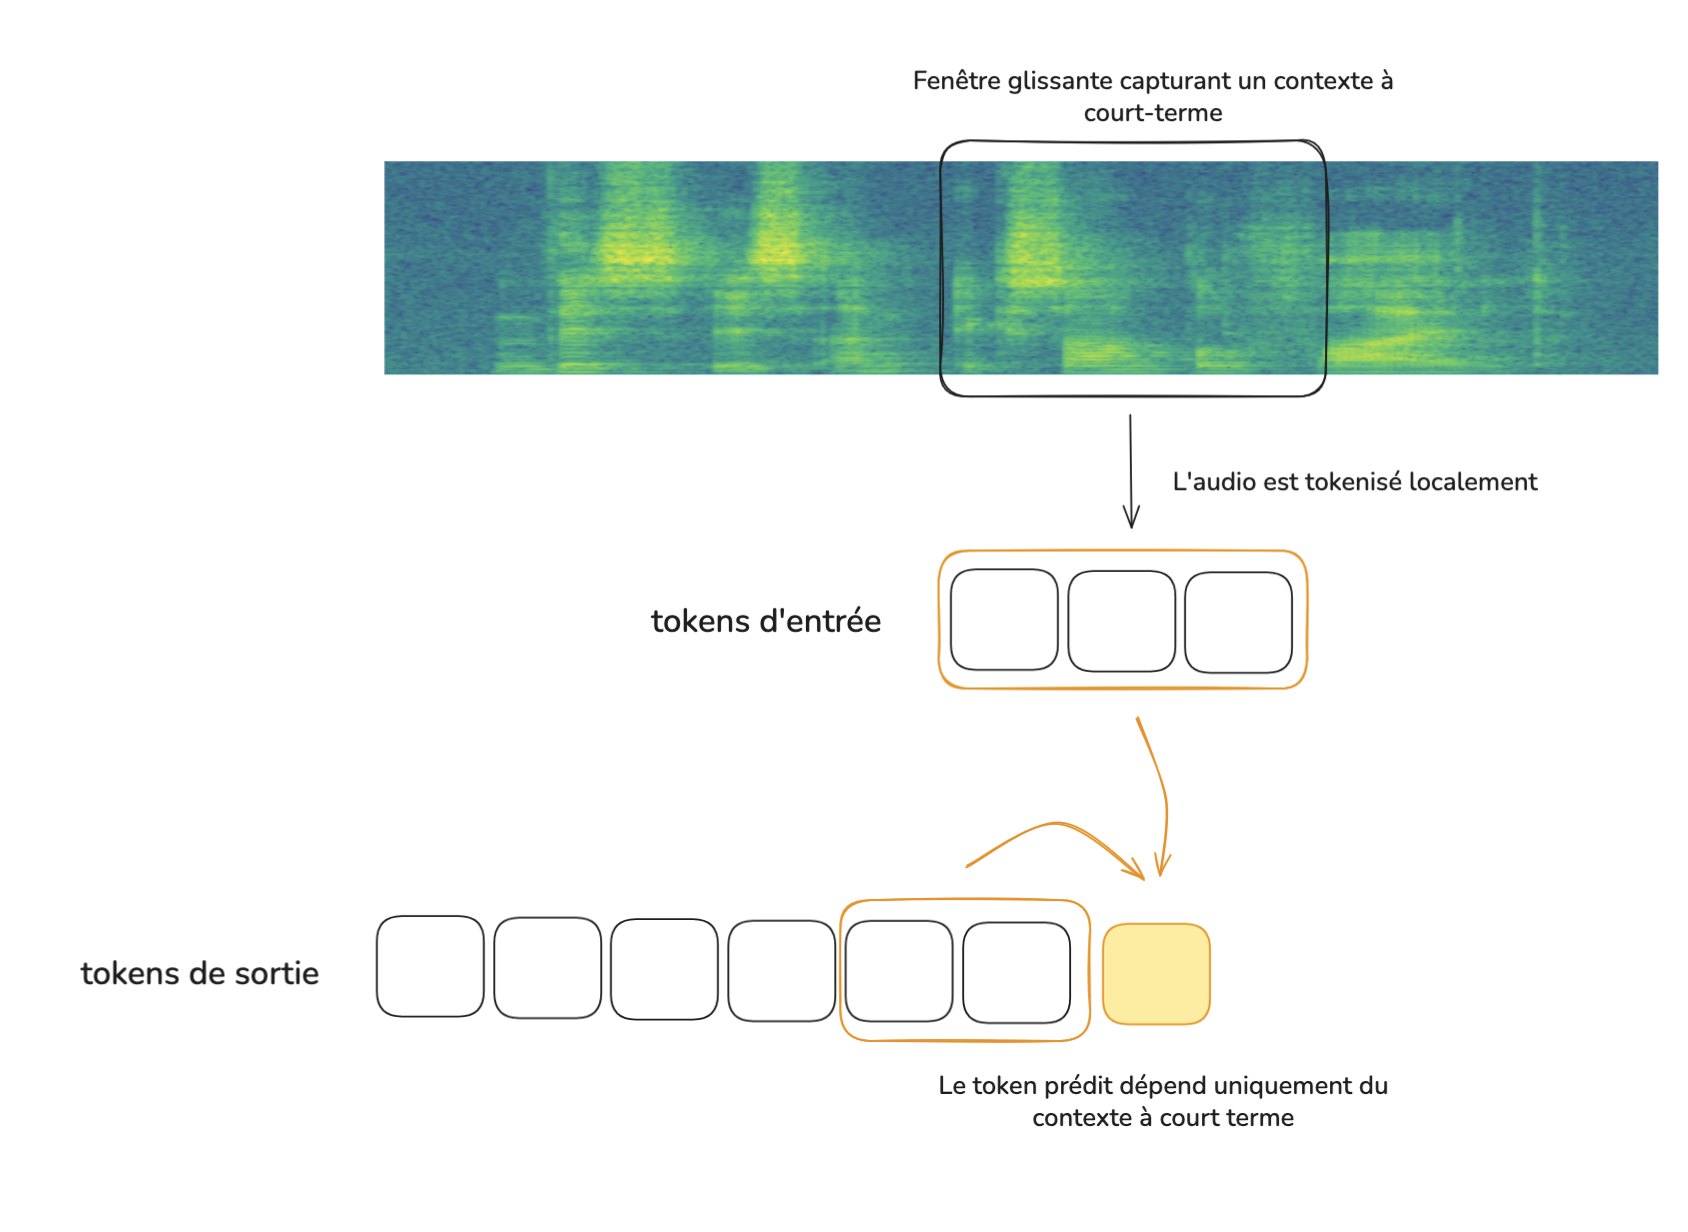
Schema semplificato di un modello ASR continuo
Grande modello di linguaggio multimodale (MLLM)
Dall'altro lato, abbiamo i LLM multimodali, che tengono conto dell'intero contesto per trascrivere ogni parola, e assicurano quindi una coerenza contestuale a lungo termine.
Le loro elevate prestazioni nei compiti legati al linguaggio assicurano una comprensione fine della registrazione, ed evitano molti fraintendimenti. Possono essere arricchiti con informazioni annesse complete, ma anche effettuare la diarizzazione in modo preciso.
Al contrario, le loro prestazioni si degradano con la lunghezza dell'input:
Quando il contesto diventa troppo ricco, le previsioni diventano rumorose.
Alcune informazioni precise possono perdersi, la generazione perde in qualità.
Il costo dell'inferenza aumenta con la dimensione dell'input.
Qui, gli interventi non possono essere marcati temporalmente in modo preciso. È possibile richiedere dei timestamps, ma saranno molto spesso allucinati dal modello.
In breve: prestazioni eccellenti su contesti moderati, ma che si degradano e diventano costose su lunghe registrazioni.
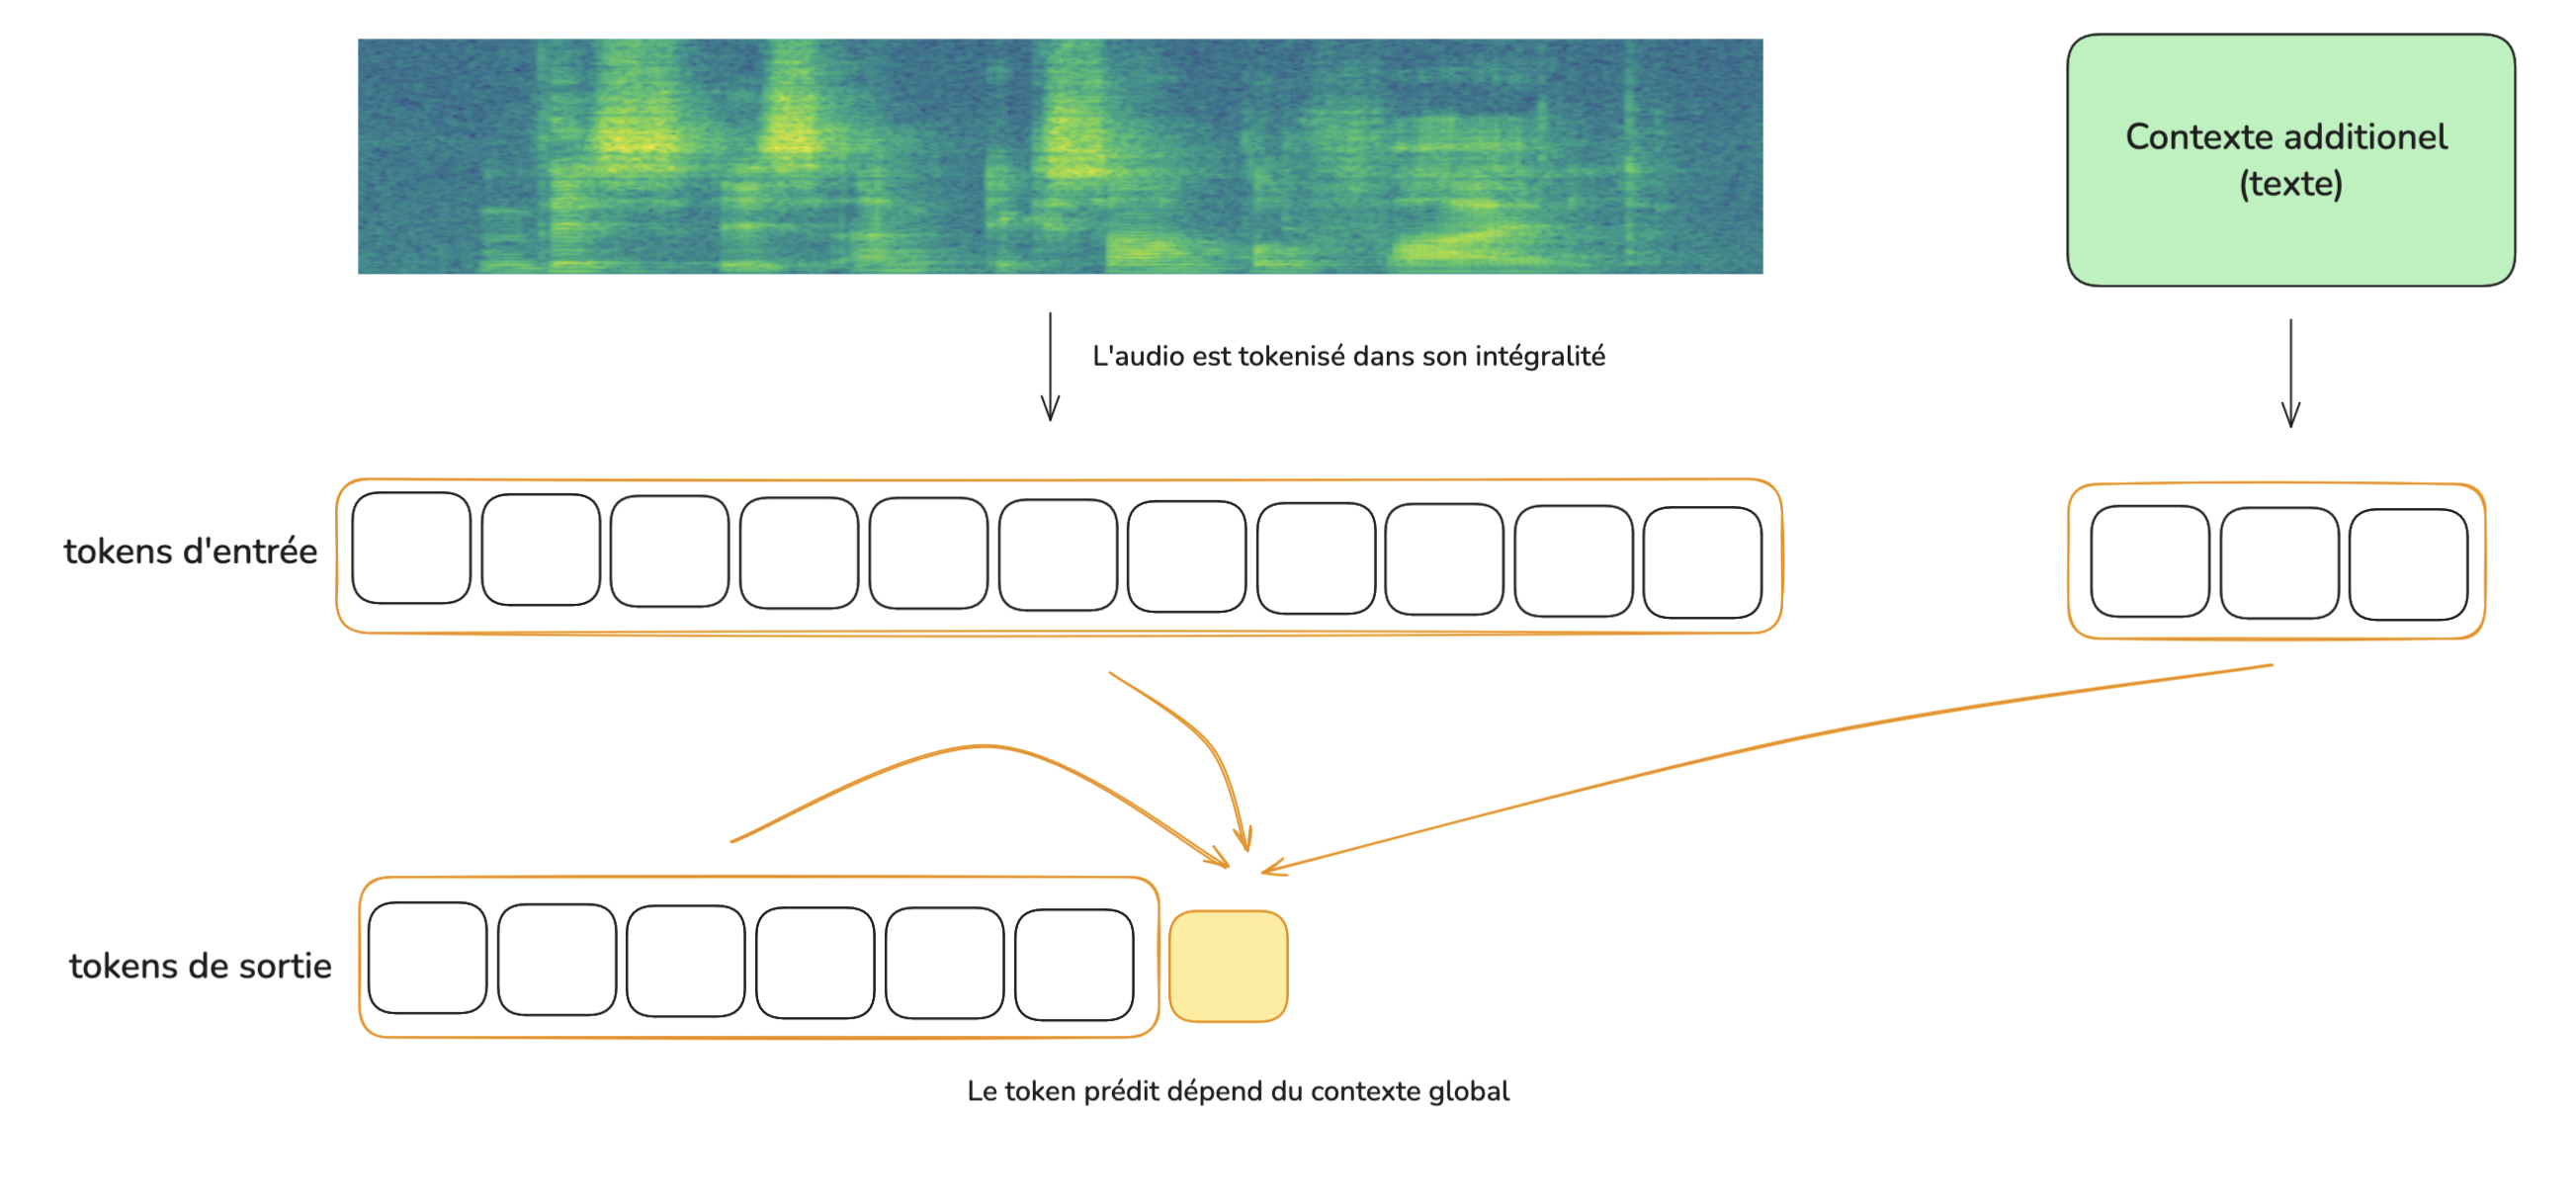
Schema semplificato di un MLLM nel contesto di una trascrizione
Si può notare che i sistemi ASR da soli hanno spesso una latenza molto migliore rispetto ai LLM multimodali e sono quindi spesso più appropriati per la trascrizione in tempo reale. Nel nostro caso, la latenza non è un problema, quindi questo criterio non viene preso in considerazione.
Piuttosto che trovare un compromesso tra i due, si possono usare i due sistemi simultaneamente.
Fase 1: Suddivisione in chunks per il MLLM
Per mantenere prestazioni ottimali del MLLM, si suddivide la registrazione in chunks di dimensione fissa (ad esempio 10-15 minuti), con sovrapposizione (overlap), ognuno trattato separatamente, iniettando ogni volta informazioni contestuali globali.
Così, il modello può usare informazioni contestuali ricche, ma senza che la lunghezza dell'input ne degradi la qualità. Gli si chiede di fornire una trascrizione diarizzata in modo abbastanza libero.
Limite: si perde il tracciamento delle identità degli oratori a lungo termine, poiché i chunks sono trattati indipendentemente: impossibile sapere se l'oratore n°2 del primo chunk è lo stesso dell'oratore n°2 dell'ultimo chunk.
Fase 2: Analisi completa tramite ASR continuo + diarizzazione
Per il sistema ASR continuo con diarizzazione, l'audio può essere analizzato in una sola volta. Il risultato avrà la forma di segmenti, associati a un interlocutore e a un indicatore temporale. Questi timestamps permettono di suddividere il risultato in chunks sincronizzati con quelli del MLLM.
Fase 3: Fusione chunk per chunk
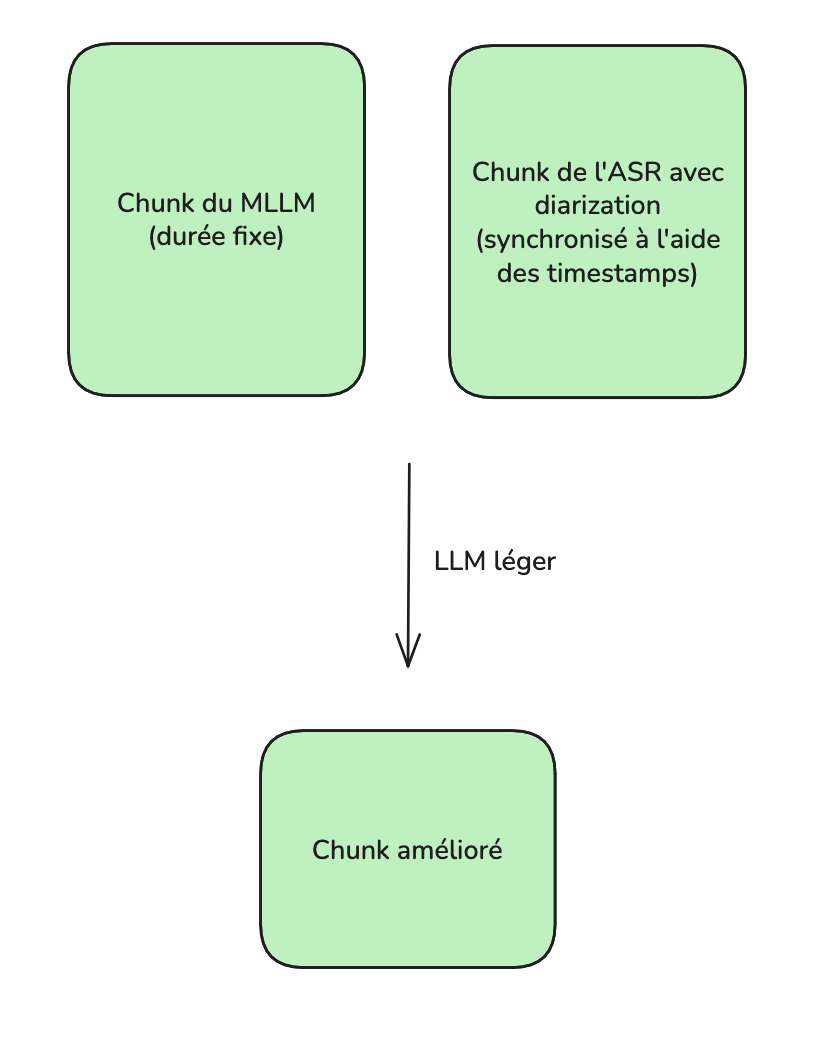
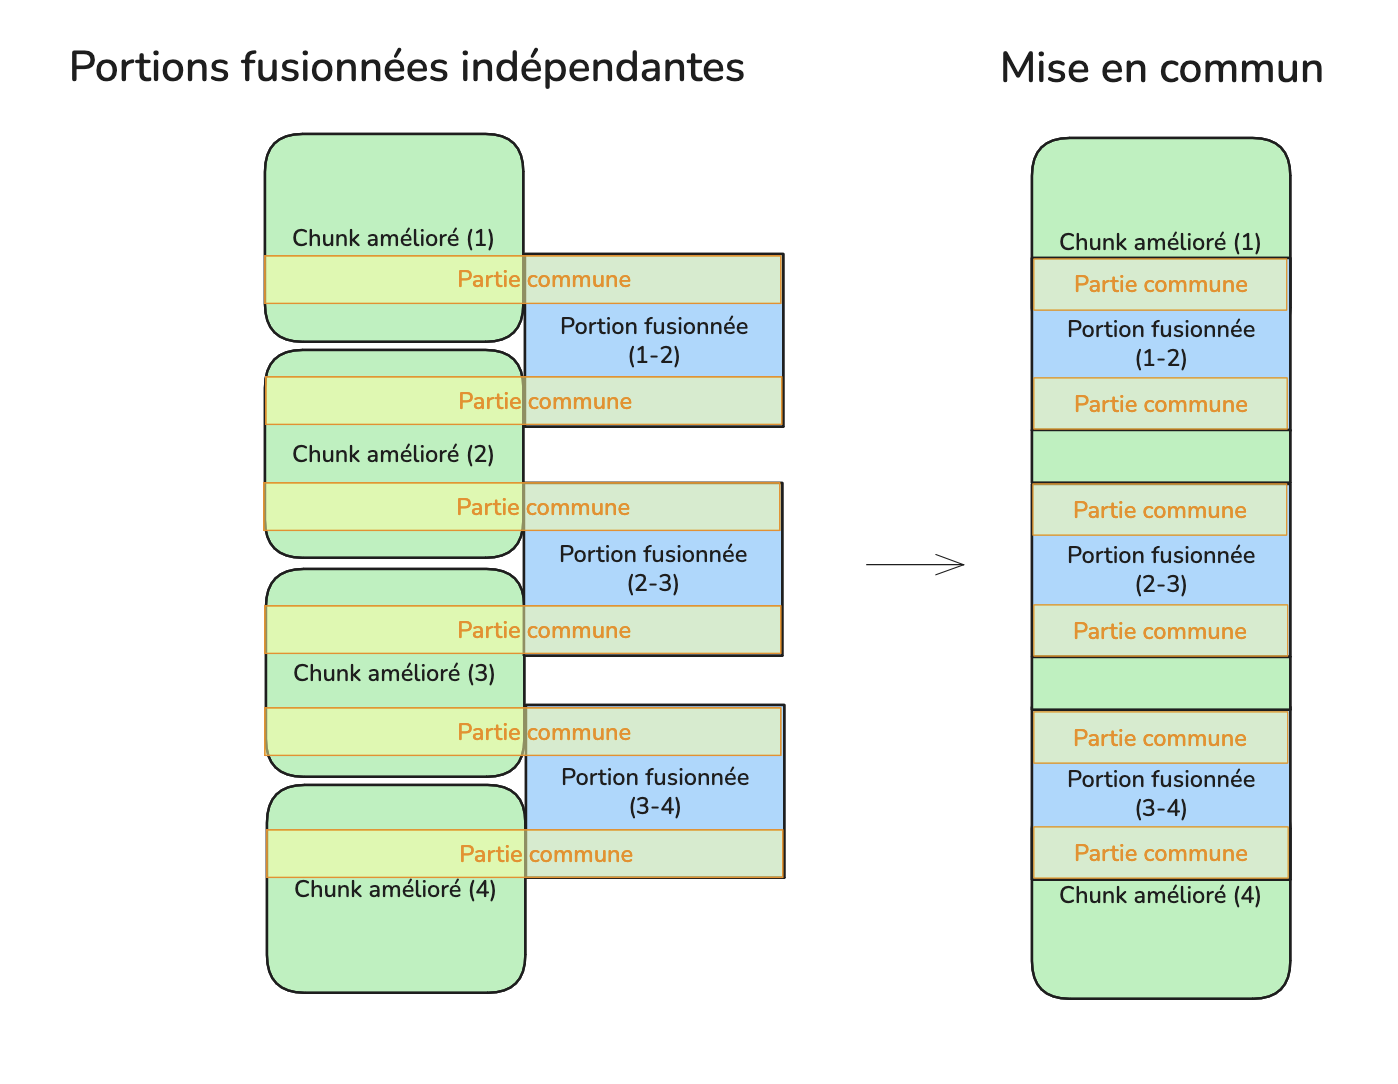
Questi chunks sincronizzati vengono poi fusi due a due con un LLM leggero e poco costoso.
Fusione dei chunks corrispondenti a una stessa porzione della registrazione:
Fase 4: Fusione finale
Infine, tutti questi chunks migliorati sono fusi per produrre una trascrizione unificata.
Un LLM leggero è utilizzato di nuovo per limitare il consumo di risorse.
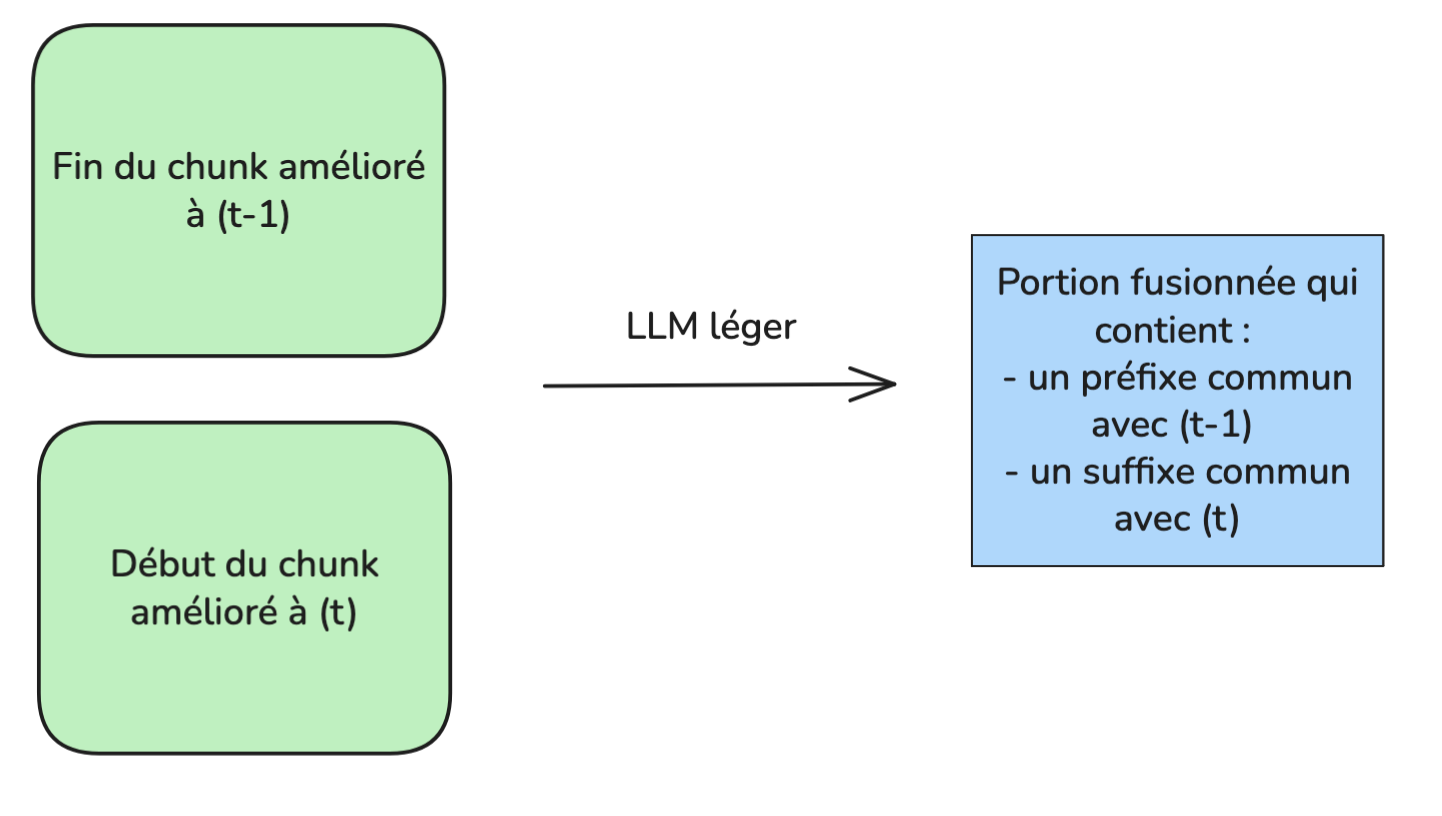
I chunks adiacenti sono fusi due a due, con sovrapposizione per facilitare le transizioni.
Il modello riceve l'istruzione di produrre un testo unico avente un prefisso comune con l'inizio del contesto precedente, e un suffisso comune con la fine del contesto seguente.
La sovrapposizione tra i chunks garantisce che nessuna informazione vada persa nel processo
Risultato: una trascrizione affidabile, coerente e diarizzata per tutta la durata.
Fusione di due chunks consecutivi, in modo da poter poi fondere facilmente tutti i chunks:
Fusione di tutti i chunks:
Analisi dei costi
I metodi di trascrizione e fusione sono indipendenti dalla lunghezza dell'input, quindi la qualità rimane costante. Il costo è anche lineare rispetto alla lunghezza dell'input, il che rende il processo fattibile per registrazioni di lunghezze arbitrariamente lunghe. Il costo del MLLM è dominante nell'insieme, il resto aggiungendo circa il 30-50%. Da un punto di vista economico, ci si aggira intorno a 0.50€ - 1€ per ora di audio.
In termini di consumo di risorse, siamo al di sotto di una singola chiamata a un MLLM, (come si potrebbe fare su un chatbot) quando la registrazione dura diverse ore. Infatti, i MLLM (e i LLM in generale) hanno un costo per token che aumenta con la lunghezza dell'input o dell'output. Limitandosi a chunks di 10-15 minuti, il consumo per token rimane moderato.
In pratica, alcuni provider per la parte ASR + diarizzazione limitano i trattamenti a 4-6 ore di audio, il che può essere un limite. Un sistema analogo può essere progettato manualmente utilizzando la libreria pyannote e un modello locale.
Metriche
I diversi metodi sono stati confrontati sul dataset FLEURS fr (registrazioni brevi con un solo oratore) per evidenziare il trasferimento di qualità dal MLLM al nostro approccio. E sul dataset SUMM-RE (riunioni con più oratori), dove il numero di errori è stato contato in LLM-as-a-judge.
FLEURS - FR
| Modalità | Raw WER |
|---|
| azure speech recognition (diarizzato) | 9.6% |
| gemini 3 flash | 3.1% |
| trascrizione duale (nostra) | 3.1% |
SUMM-RE - FR
| Modalità | discrepanze semantiche (minori) | discrepanze semantiche (maggiori) | precisione nell'attribuzione dell'oratore |
|---|
| azure speech recognition (diarizzato) | 12 | 2 | 86% |
| gemini 3 flash | 3 | 0 | |
| trascrizione duale (nostra) | 2 | 0 | 88% |
Conclusione
Il metodo qui descritto permette di trasporre la qualità di trascrizione che si può ottenere su audio brevi, a registrazioni arbitrariamente lunghe. Ciò si accompagna a un aumento sostanziale dei costi, ma che è da relativizzare con il costo totale del sistema, di cui la trascrizione è solo una fase. In questo modo, si evitano numerosi errori che sarebbero incorreggibili nel passaggio dalla trascrizione al resoconto finale.
Buone pratiche
Includere un overlap tra i chunks per facilitare la fusione (circa 30s - 1 minuto).
Utilizzare chunks sufficientemente lunghi affinché il MLLM tragga vantaggio dalle informazioni contestuali, ma sufficientemente brevi per non degradarne le prestazioni (10-20 minuti è un buon compromesso).
Se possibile, impostare la temperatura a un valore prossimo allo 0 nel MLLM per limitare il rumore
Un sistema più semplice di questo sarà un'opzione migliore se l'obiettivo è trascrivere audio brevi (qualche decina di minuti).