LLMs, gekoppelt mit OCR-Systemen, ermöglichen heute die Automatisierung der Verarbeitung von PDF- oder Bilddokumenten: Zusammenfassungen, Extraktion strukturierter Daten, Befüllung von Chatbots… Aber diese Modelle halluzinieren. Und für kritische Aufgaben, bei denen Fehler nicht toleriert werden, muss ein Mensch jedes Ergebnis überprüfen.
Das Problem: Diese Überprüfung ist oft so langwierig wie die Arbeit selbst zu erledigen. Angesichts eines 50-seitigen Dokuments muss der Prüfer die relevanten Informationen finden, bevor er die Antwort des LLM validieren kann, eine Arbeit, die das Modell bereits selbst erledigt hat, ohne eine verwertbare Spur zu hinterlassen.
Die hier beschriebene Lösung basiert auf einer einfachen Feststellung: Das LLM weiss, wo es die Information gefunden hat, man muss es nur bitten, es zu zeigen. Durch die Nutzung der von der OCR bereitgestellten Lokalisierungsmetadaten ist es möglich, den Textabschnitt, der jedes Element der Antwort begründet, direkt im Quelldokument hervorzuheben. Dies nennt man einen visuellen Beweis.
Beweise, ja, aber auf welcher Ebene?
Die Idee, Benutzern Beweise zu liefern, ist nicht neu. Verbundene Chatbots (ChatGPT, Perplexity, Grok…) zeigen anklickbare Links zu ihren Quellen an. Aber diese Beweise bleiben « auf hoher Ebene »: Zur Überprüfung muss man die Quelle noch lesen, was langwierig sein kann.
Die Google-Suchmaschine bietet ein besseres Modell. Bei bestimmten Anfragen listet sie nicht nur Links auf: Sie zeigt den genauen Auszug der Seite an, der die Antwort enthält, und hebt die relevante Passage hervor. Es ist dieses Granularitätsniveau, das das hier vorgestellte System auf die Dokumentenverarbeitung mittels OCR + LLM überträgt.
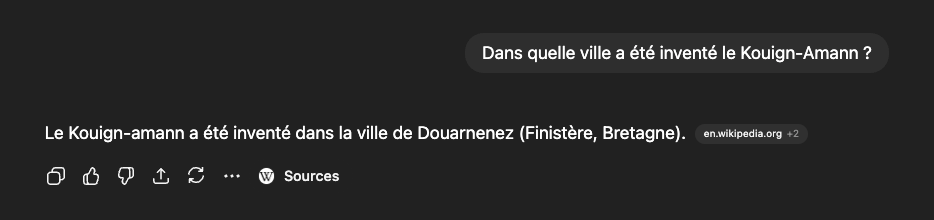
Beispiel für einen Beweis in einem verbundenen Chatbot (ChatGPT)
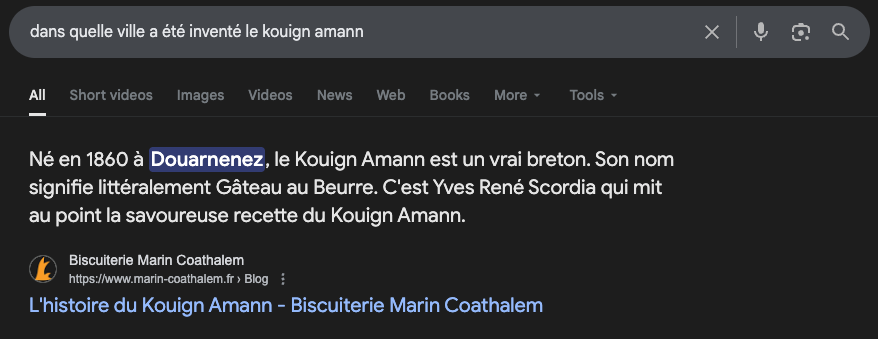
Beispiel für einen visuellen Beweis in einer Google-Suche
Die Benutzererfahrung: Klicken zum Überprüfen
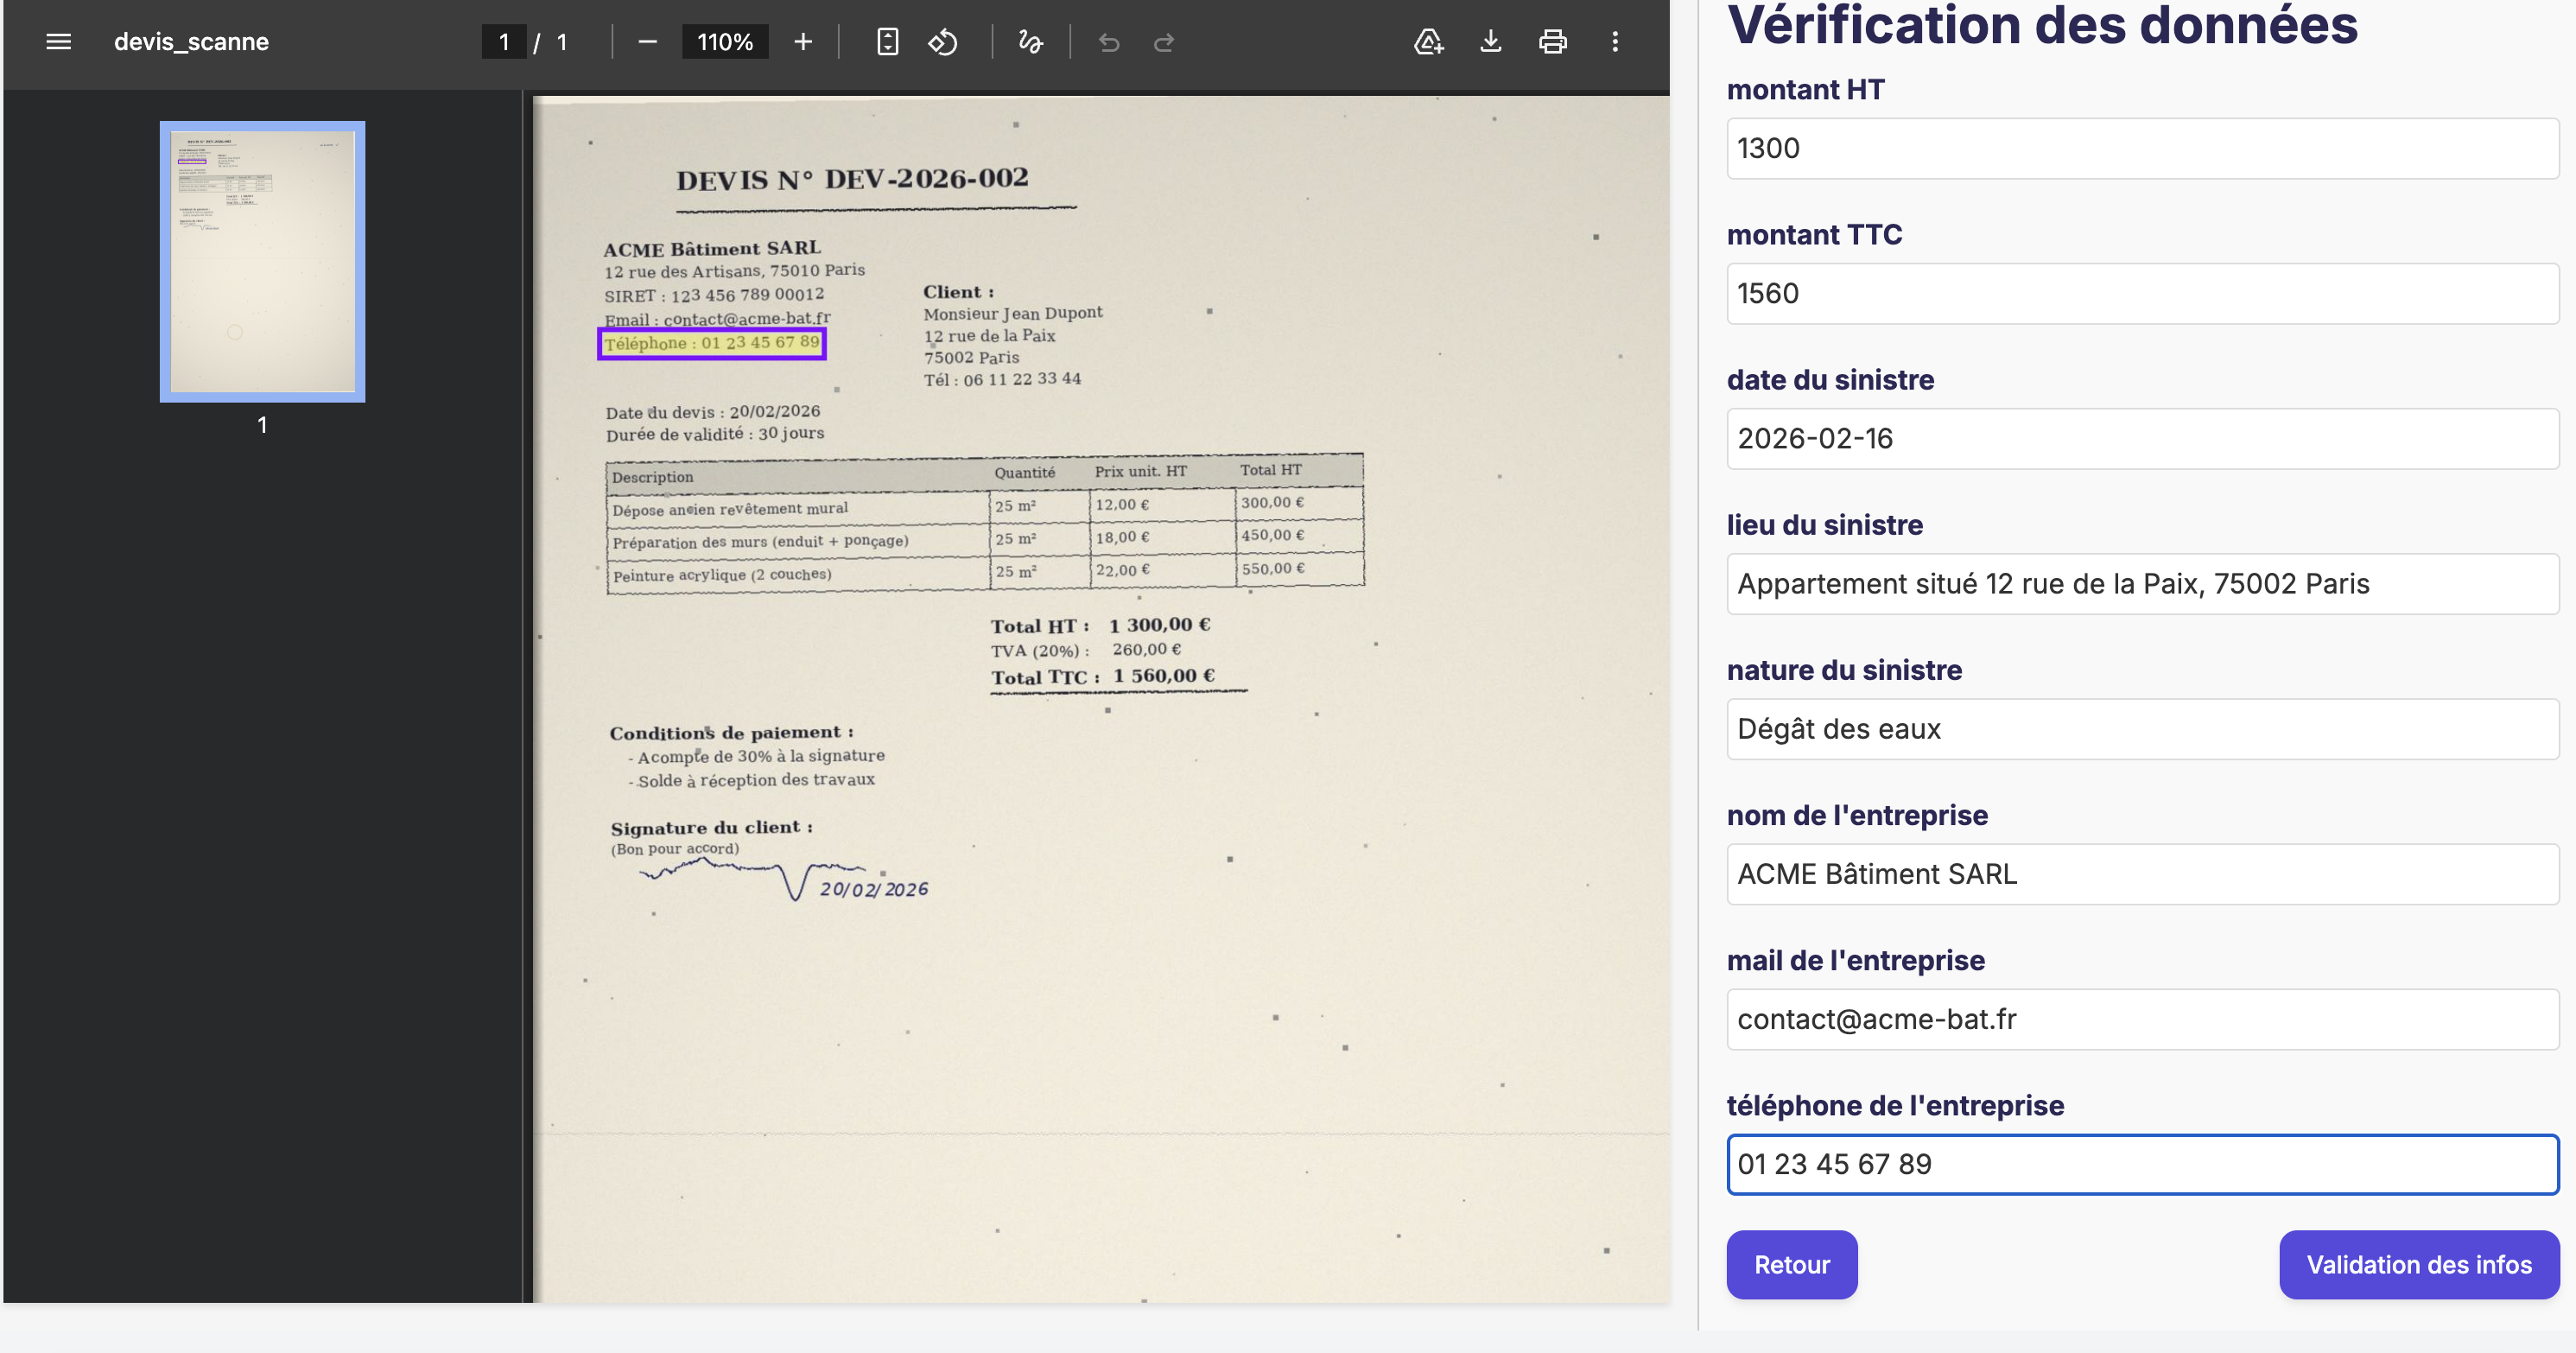
Die Oberfläche teilt sich in zwei Bereiche. Links das Ergebnis der LLM-Inferenz (Zusammenfassung, strukturierte Daten, Chatbot-Antwort…). Rechts das Quelldokument. Wenn der Benutzer auf ein Element des Ergebnisses klickt, zeigt der rechte Bereich automatisch die betreffende Seite mit dem relevanten, hervorgehobenen Textabschnitt an.
Das Bild im Artikelkopf illustriert diese Benutzeroberfläche.
Was die OCR liefert
Das System stützt sich auf AWS Textract als OCR-Engine (andere Tools liefern äquivalente Metadaten). Für jedes erkannte Element gibt Textract einen Block zurück, der insbesondere den extrahierten Roh-Text (Text), die Position auf der Seite in Form einer Bounding Box (BoundingBox), der Blocktyp (PAGE, LINE, WORD, TABLE, CELL, IMAGE…) und die Eltern-Kind-Beziehungen zwischen Blöcken (Relationships).
{
    "BlockType": "LINE",
    "Confidence": 97.36617279052734,
    "Text": "MEUBLES à PIZZA",
    "Geometry": {
        "BoundingBox": {
            "Width": 0.2342921942472458,
            "Height": 0.02162465639412403,
            "Left": 0.7166793942451477,
            "Top": 0.028492335230112076
        },
        "Polygon": [
            { "X": 0.7167330980300903, "Y": 0.02968931570649147 },
            { "X": 0.9509715437889099, "Y": 0.028492335230112076 },
            { "X": 0.9509004354476929, "Y": 0.04892276972532272 },
            { "X": 0.7166793942451477, "Y": 0.05011698976159096 }
        ]
    },
    "Id": "63422f23-5ac4-4418-b002-9776ed79301b",
    "Relationships": [
        {
            "Type": "CHILD",
            "Ids": [
                "9882688f-4d80-4835-87e2-3f1486295e1f",
                "29ca488f-2fec-4464-9c7d-2c4b616e9a4d",
                "f9c31d27-1fdc-460c-9fdd-5b8ee69d3e46"
            ]
        }
    ]
}
Diese Bounding Boxes ermöglichen es, zu wissen, welche Pixel hervorgehoben werden sollen, und die Baumstruktur ermöglicht es, den Granularitätsgrad des Nachweises (Wort, Zeile, Tabelle…) zu kontrollieren.
Die Herausforderung des Prompt Engineerings: sparsam mit Tokens umgehen
In einer klassischen OCR + LLM Pipeline wird nur der Rohtext an das Modell gesendet. Alle restlichen Metadaten dienen ausschliesslich der Formatierung (z.B. Tabellen in Markdown). Das Senden des gesamten Textract-JSON an das LLM wäre ein desaströser, naiver Ansatz: ungefähr 100 000 Tokens pro Seite, verglichen mit 1 000 Tokens für das klassische Parsing.
Der Trick besteht darin, Metadaten nur auf einer hohen Granularitätsstufe hinzuzufügen. Konkret werden nur Blöcke des Typs Zeile und Tabelle werden im Prompt über Tags nummeriert und markiert <LINE {id}> und <TABLE {id}>. Blöcke feinerer Granularität (Wörter, Zellen) erhalten keine expliziten Metadaten: Das LLM kann sie über ihr Elternteil und ihren Textwert referenzieren.
Diese Wahl der Granularität ist nicht willkürlich. Angesichts der Struktur der Textract-Blöcke kann jeder Nachweis vier Formen annehmen: einen Textblock (ungefähr ein Wort), eine Zeile, eine Tabelle oder die Zelle einer Tabelle. Für jede Aufgabe kann das LLM mehrere Nachweise unterschiedlicher Art zurückgeben – zum Beispiel eine Zeile und drei Tabellenzellen.
Die Ausgabe des LLM mit den OCR-Blöcken abgleichen
Da nicht alle Metadaten im Prompt enthalten sind, kann das LLM auf Blöcke verweisen, die in der OCR-Ausgabe nicht so existieren. Typisches Beispiel: Die OCR hat 6 x 7 als drei separate Blöcke (6, x, 7), aber das LLM referenziert sie als einen einzigen Block. Ein deterministischer Nachbearbeitungsschritt löst diese Diskrepanz, indem er durch textuelle Ähnlichkeit (fuzzratio), die OCR-Blöcke identifiziert, deren Kombination am besten der Referenz des LLM entspricht.
Die Antwortstruktur: Wert und Nachweis duplizieren
Damit das System funktioniert, muss die Antwort des LLM sowohl das Ergebnis als auch die zugehörigen Lokalisierungsmetadaten enthalten. In der Praxis bedeutet dies, strukturierte Ausgaben (JSON) zu verwenden, indem jedes Feld in einen Wert und einen Nachweis dupliziert wird.
Anstelle einer klassischen Extraktion:
{
  "temperature": "4°C",
  "power (kW)": 42,
  "description": "SOME VERY LONG TEXT"
}
Die Antwort hat diese Form:
{
  "temperature": {
    "value": "4°C",
    "proof": [{ "type": "WORD", "line": 2, "value": "4°C" }]
  },
  "power (kW)": {
    "value": 42,
    "proof": [{ "type": "WORD", "line": 5, "value": "6 x 7000 Watts" }]
  },
  "description": {
    "value": "SOME VERY LONG TEXT",
    "proof": [
      { "type": "LINE", "id": 19 },
      { "type": "LINE", "id": 20 }
    ]
  }
}
Die Anzeige: das Quellbild annotieren
Sobald die Lokalisierungsmetadaten auf die Textract-Blöcke zurückgeführt wurden, verfügt das System über die Koordinaten (zwischen 0 und 1) der vier Ecken jeder Bounding Box auf dem Dokument.
Die Bilder werden vom Backend annotiert. Das Frontend hat somit für jedes extrahierte Datum Zugriff auf das entsprechende annotierte Bild.
Technisch gesehen basiert die Annotation der Bilder auf der Bibliothek sharp, und die PDF-Verarbeitung auf pdf-lib.