Gli LLM accoppiati a sistemi OCR permettono oggi di automatizzare l'elaborazione di documenti PDF o immagini: riassunti, estrazione di dati strutturati, alimentazione di chatbot… Ma questi modelli allucinano. E per compiti critici dove l'errore non è tollerato, un umano deve verificare ogni risultato.
Il problema: questa verifica è spesso tanto lunga quanto fare il lavoro da soli. Di fronte a un documento di 50 pagine, il verificatore deve trovare l'informazione pertinente prima ancora di poter validare la risposta dell'LLM, un lavoro che il modello ha già fatto da parte sua, senza lasciarne traccia utilizzabile.
La soluzione qui descritta si basa su una constatazione semplice: l'LLM sa dove ha trovato l'informazione, basta chiedergli di mostrarla. Sfruttando i metadati di localizzazione forniti dall'OCR, è possibile evidenziare direttamente sul documento sorgente il segmento di testo che giustifica ogni elemento della risposta. Questo è ciò che chiamiamo una prova visiva.
Delle prove, sì ma a che livello?
L'idea di fornire prove all'utente non è nuova. I chatbot connessi (ChatGPT, Perplexity, Grok…) visualizzano link cliccabili verso le loro fonti. Ma queste prove rimangono di « alto livello »: per verificare, bisogna ancora leggere la fonte, il che può richiedere molto tempo.
Il motore di ricerca Google offre un modello migliore. Per alcune query, non si limita a elencare link: visualizza l'estratto preciso della pagina che contiene la risposta, evidenziando il passaggio pertinente. È questo livello di granularità che il sistema qui presentato trasporta all'elaborazione di documenti tramite OCR + LLM.
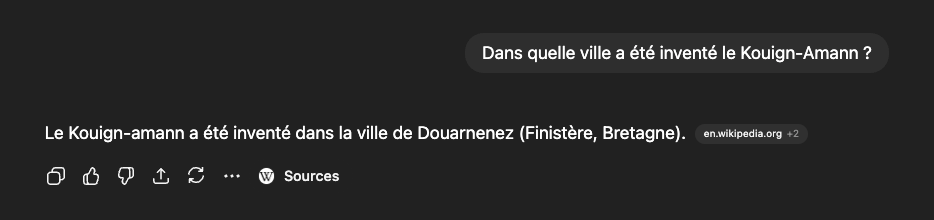
Esempio di prova in un chatbot connesso (ChatGPT)
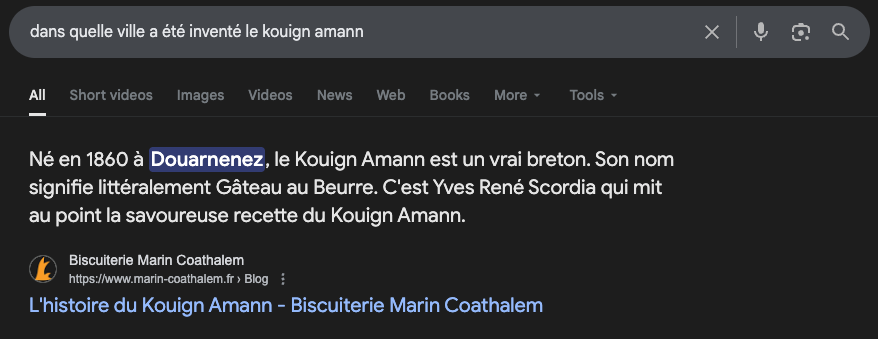
Esempio di prova visiva in una ricerca Google
L'esperienza utente: cliccare per verificare
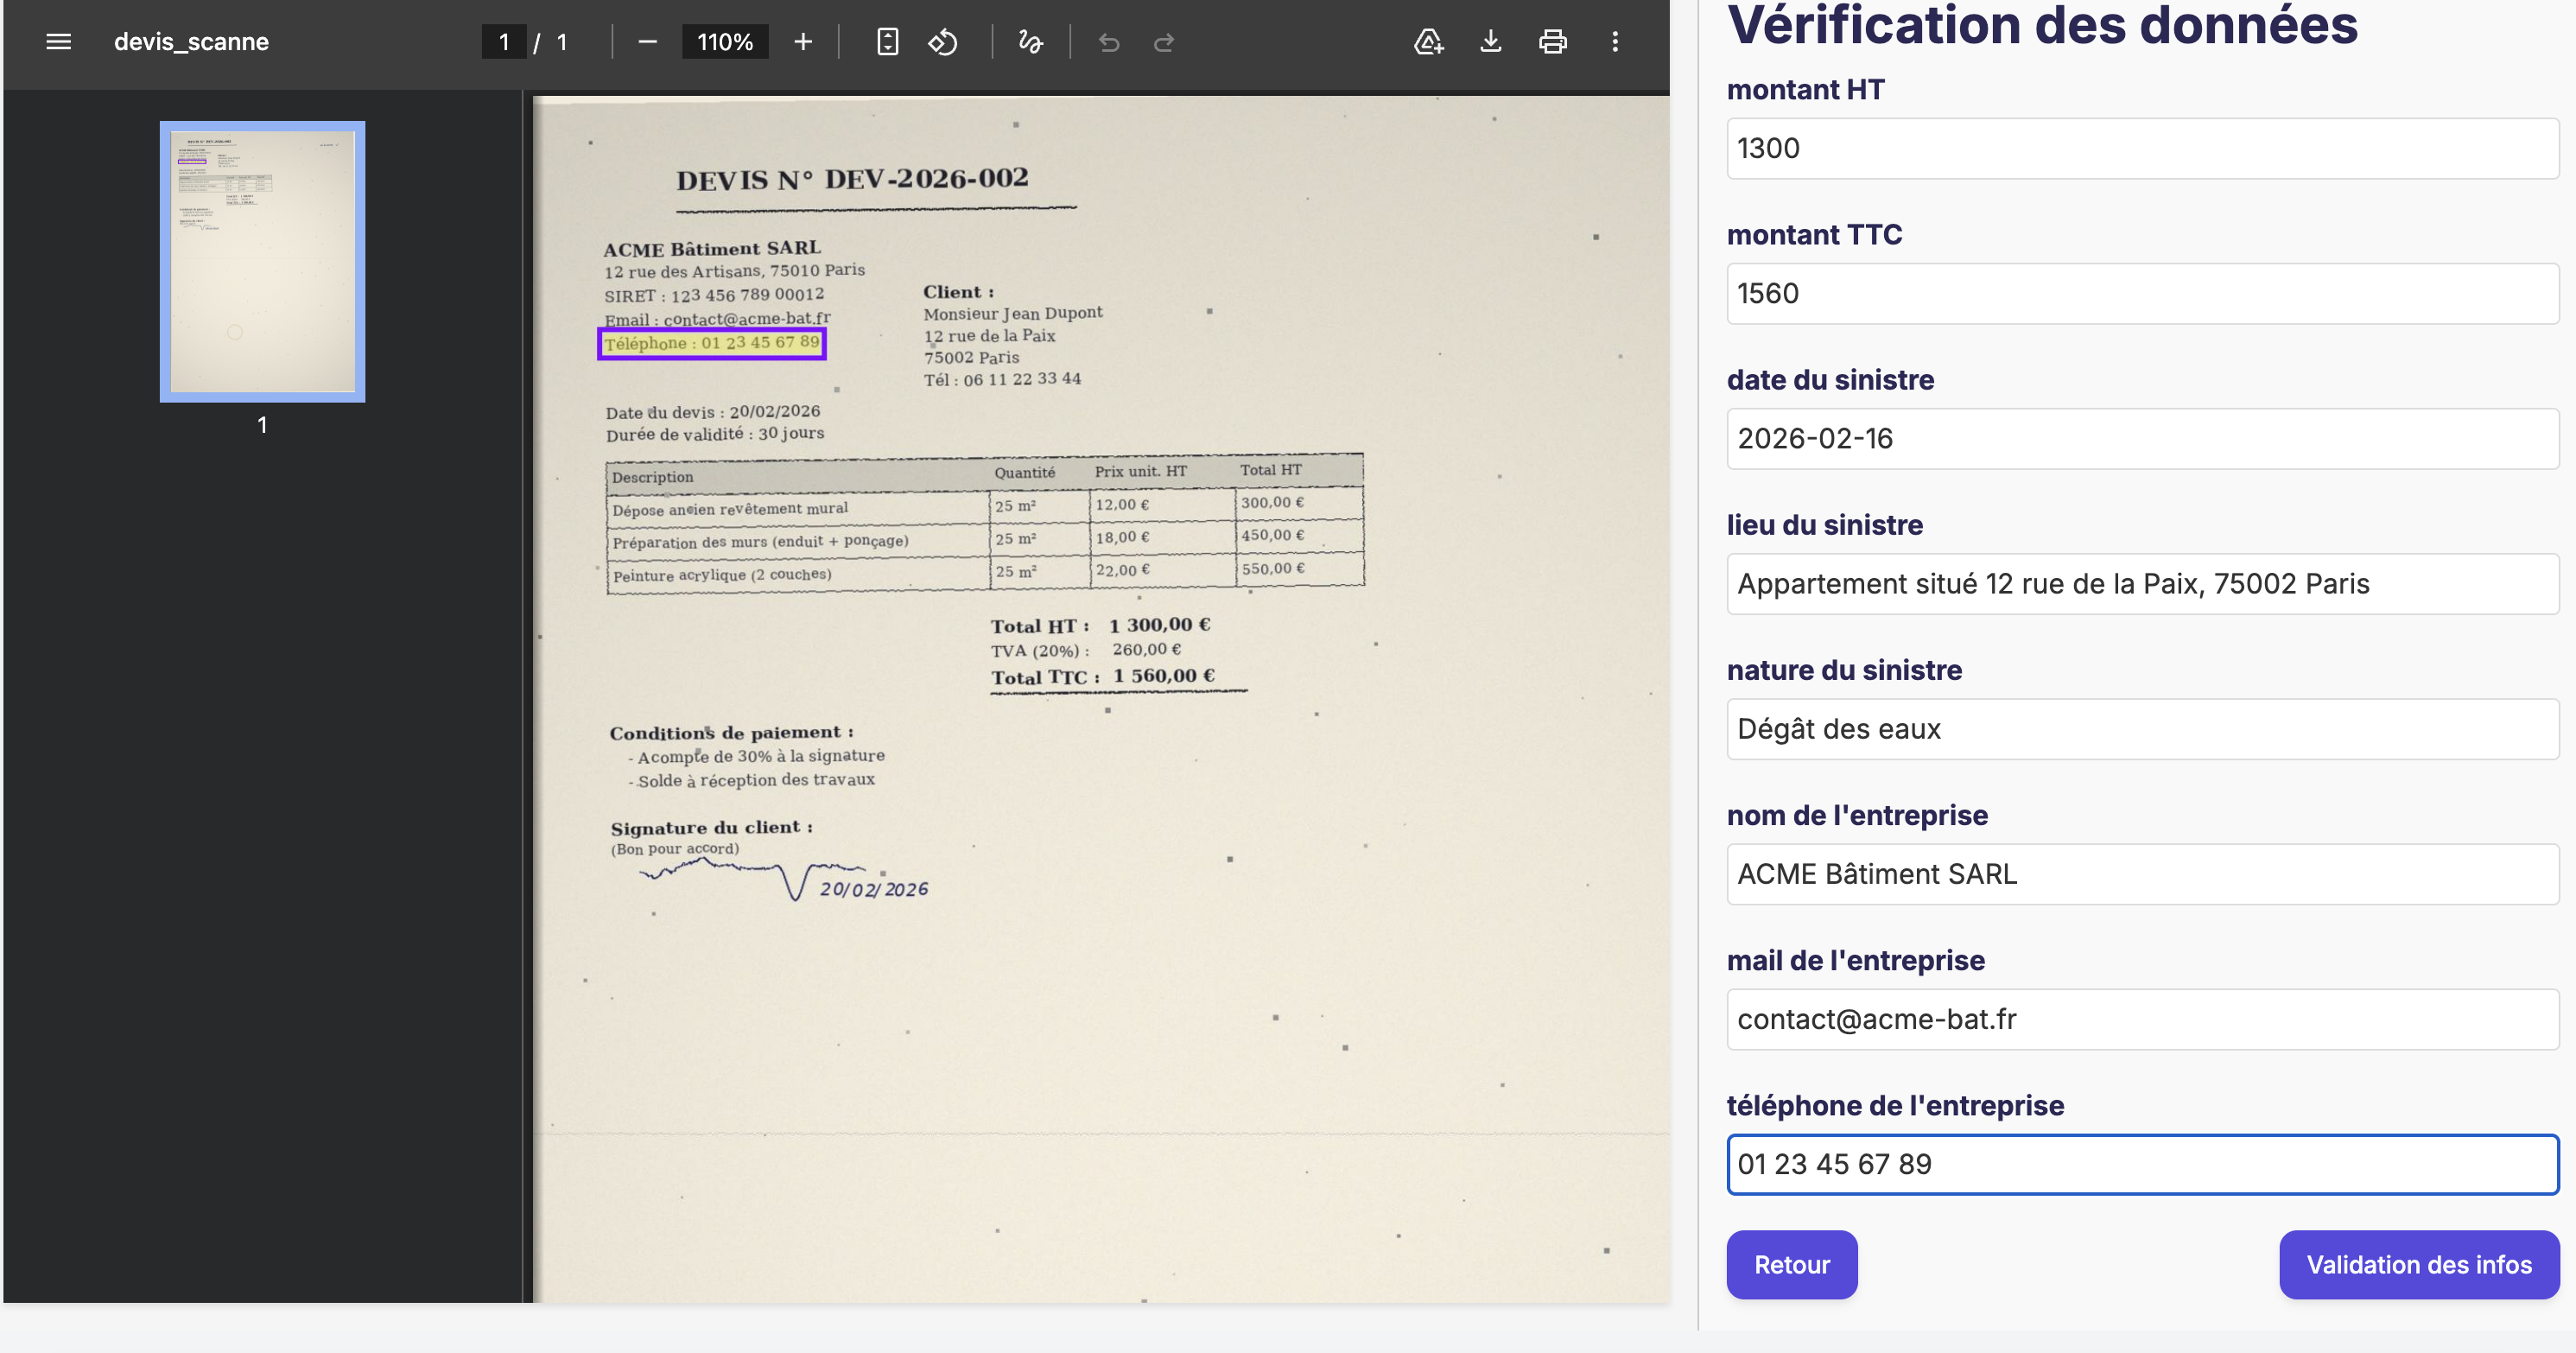
L'interfaccia si divide in due pannelli. A sinistra, il risultato dell'inferenza dell'LLM (riassunto, dati strutturati, risposta del chatbot…). A destra, il documento sorgente. Quando l'utente clicca su un elemento del risultato, il pannello destro visualizza automaticamente la pagina interessata con il segmento di testo pertinente evidenziato.
L'immagine nell'intestazione dell'articolo illustra questa interfaccia utente.
Ciò che fornisce l'OCR
Il sistema si basa su AWS Textract come motore OCR (altri strumenti forniscono metadati equivalenti). Per ogni elemento rilevato, Textract restituisce un blocco che contiene in particolare il testo grezzo estratto (Text), la posizione sulla pagina sotto forma di bounding box (BoundingBox), il tipo di blocco (PAGE, LINE, WORD, TABLE, CELL, IMAGE…) e le relazioni genitore-figlio tra blocchi (Relationships).
{
    "BlockType": "LINE",
    "Confidence": 97.36617279052734,
    "Text": "MEUBLES à PIZZA",
    "Geometry": {
        "BoundingBox": {
            "Width": 0.2342921942472458,
            "Height": 0.02162465639412403,
            "Left": 0.7166793942451477,
            "Top": 0.028492335230112076
        },
        "Polygon": [
            { "X": 0.7167330980300903, "Y": 0.02968931570649147 },
            { "X": 0.9509715437889099, "Y": 0.028492335230112076 },
            { "X": 0.9509004354476929, "Y": 0.04892276972532272 },
            { "X": 0.7166793942451477, "Y": 0.05011698976159096 }
        ]
    },
    "Id": "63422f23-5ac4-4418-b002-9776ed79301b",
    "Relationships": [
        {
            "Type": "CHILD",
            "Ids": [
                "9882688f-4d80-4835-87e2-3f1486295e1f",
                "29ca488f-2fec-4464-9c7d-2c4b616e9a4d",
                "f9c31d27-1fdc-460c-9fdd-5b8ee69d3e46"
            ]
        }
    ]
}
Sono queste bounding box che permettono di sapere quali pixel evidenziare, e la struttura ad albero che permette di controllare il livello di granularità della prova (parola, riga, tabella…).
La sfida del prompt engineering: rimanere sobri in token
In una pipeline classica OCR + LLM, solo il testo grezzo viene inviato al modello. Tutto il resto dei metadati serve unicamente alla formattazione (tabelle in markdown, per esempio). Inviare l'intera JSON Textract al LLM sarebbe un approccio ingenuo disastroso: circa 100.000 token per pagina, contro 1.000 token per il parsing classico.
Il trucco consiste nell'aggiungere i metadati solo a un livello di granularità elevato. In concreto, solo i blocchi di tipo riga e tabella sono numerati e taggati nel prompt tramite tag <LINE {id}> e <TABLE {id}>. I blocchi di granularità più fine (parole, celle) non ricevono metadati espliciti: il LLM può riferirvisi tramite il loro genitore e il loro valore testuale.
Questa scelta di granularità non è arbitraria. Data la struttura dei blocchi Textract, ogni prova può assumere quattro forme: un blocco di testo (circa una parola), una riga, una tabella o la cella di una tabella. Per ogni compito, il LLM può risalire a più prove di natura diversa - per esempio una riga e tre celle di tabella.
Riconciliare l'output del LLM con i blocchi OCR
Dato che non tutte le metadati sono incluse nel prompt, il LLM può fare riferimento a blocchi che non esistono tali e quali nell'output OCR. Esempio tipico: l'OCR ha estratto 6 x 7 come tre blocchi distinti (6, x, 7), ma il LLM li riferisce come un blocco unico. Un passaggio deterministico di post-elaborazione risolve questo disallineamento identificando, per similarità testuale (fuzzratio), i blocchi OCR la cui combinazione corrisponde al meglio al riferimento del LLM.
La struttura di risposta: sdoppiare valore e prova
Affinché il sistema funzioni, la risposta del LLM deve contenere sia il risultato che i metadati di localizzazione associati. In pratica, ciò equivale a utilizzare gli output strutturati (JSON) sdoppiando ogni campo in un valore e una prova.
Invece di un'estrazione classica:
{
  "temperature": "4°C",
  "power (kW)": 42,
  "description": "SOME VERY LONG TEXT"
}
La risposta assume questa forma:
{
  "temperature": {
    "value": "4°C",
    "proof": [{ "type": "WORD", "line": 2, "value": "4°C" }]
  },
  "power (kW)": {
    "value": 42,
    "proof": [{ "type": "WORD", "line": 5, "value": "6 x 7000 Watts" }]
  },
  "description": {
    "value": "SOME VERY LONG TEXT",
    "proof": [
      { "type": "LINE", "id": 19 },
      { "type": "LINE", "id": 20 }
    ]
  }
}
La visualizzazione: annotare l'immagine sorgente
Una volta che i metadati di localizzazione sono stati ricondotti ai blocchi Textract, il sistema dispone delle coordinate (tra 0 e 1) dei quattro angoli di ogni bounding box sul documento.
Le immagini sono annotate dal backend. Il frontend ha così accesso per ogni dato estratto all'immagine annotata corrispondente.
Dal lato tecnico, l'annotazione delle immagini si basa sulla libreria sharp, e l'elaborazione dei PDF su pdf-lib.