2016 – AlphaGo versus Lee Sedol – wann wird AI kreativ?
Am 15. März 2016 ging das fünfte Go-Spiel zwischen Lee Sedol, dem zweiterfolgreichsten Spieler der Geschichte, und
AlphaGo, einem Computerprogramm, entwickelt von Deepmind, einem britischen Unternehmen, das zwei Jahre zuvor von Google übernommen wurde, zu Ende. AlphaGo gewann den Wettbewerb mit 4 Siegen und 1 Niederlage.
Über den 37. Zug des zweiten Spiels sagte Sedol: „Ich dachte, AlphaGo basiere auf Wahrscheinlichkeitsberechnungen und sei nur eine einfache Maschine. Aber als ich diesen Zug sah, änderte ich meine Meinung. Sicherlich ist AlphaGo kreativ. Dieser Zug war wirklich kreativ und schön.“
Das Go-Spiel wurde lange als grosse Herausforderung für AI angesehen: Das Spiel weist 10 hoch 170 mögliche Brettkonfigurationen auf, das heisst 1 Googol (10 hoch 100) Mal mehr als das Schachspiel. Das ist sogar mehr als die
Anzahl Atome im bekannten Universum.
AlphaGo ist ein AI-System, das zwei neuronale Netzwerke (Policy Network und Value Network) und fortschrittliche Suchalgorithmen kombiniert. Das Training von AlphaGo nutzte Reinforcement Learning: AlphaGo spielte Millionen von Partien gegen sich selbst.
Trotz seiner astronomischen mathematischen Komplexität besteht das Go-Spiel „einfach“ aus einem 19x19-Feld und 361 Steinen. Dieses endliche Universum scheint intuitiv einfacher für eine Maschine zu meistern zu sein, als sich im physischen Universum (Robotik) zu bewegen und darauf einzuwirken, oder... die Mathematik, von der Banach sagte, dass sie „die schönste und mächtigste Schöpfung des menschlichen Geistes“ bleibt. Bis jetzt? Das werden wir versuchen herauszufinden.
Der MATH-Benchmark
Die MATH-Probleme decken 7 Themen ab, darunter Geometrie, Lineare Algebra und Zahlentheorie, und sind in 5 Schwierigkeitsgrade eingeteilt. Die menschliche Leistung bei MATH ist nicht perfekt: Ein Informatik-Doktorand hätte eine Leistung von etwa 40%, während ein dreifacher Goldmedaillengewinner der Internationalen Mathematik-Olympiade eine Leistung von etwa 90% hätte.
Und die AI-Modelle? Ihre Leistung variiert von 3.0% bis 6.9%, mit einem Maximum von 15% bei den einfachsten Problemen. Die getesteten Modelle waren GPT-2 (von 100 Millionen Parametern bis 1.5 Milliarden) und GPT-3 (von 13 bis 175 Milliarden Parametern), Modelle, die heute überholt sind.
Im Jahr 2021 schlossen die Autoren, dass im Gegensatz zu vielen anderen textbasierten Aufgaben das „Skalieren“ von Transformer-basierten Modellen (die die
Grundlage der Generativen AI) es nicht ermöglicht, den MATH-Benchmark zu lösen.
Und heute?
Die OpenAI „o“-Modelle und der AIME-Benchmark
Weniger als 4 Jahre später ist die Situation etwas anders: Das
OpenAI o1-Modell, das im September 2024 veröffentlicht wurde, würde auf dem MATH-Benchmark eine Leistung von 94.8% erreichen. Dieser Benchmark wird daher nun als gesättigt betrachtet. o1 erreicht ausserdem eine Leistung von 83.3% bei den Problemen des AIME 2024 Wettbewerbs, einem Benchmark mit höherem Schwierigkeitsgrad.
AIME (für American Invitational Mathematics Examination) ist ein Datensatz, der die Probleme des gleichnamigen Wettbewerbs, der seit 1983 stattfindet, enthält. Es ist eine 3-stündige Prüfung mit 15 Fragen, die für die besten amerikanischen Gymnasiasten in Mathematik bestimmt ist. Die zugehörigen Probleme sind komplex, erfordern kreative Ansätze und haben alle als Lösung eine ganze Zahl zwischen 0 und 999.
Die OpenAI-Modelle der „o“-Familie sind die ersten ihrer Kategorie, mit einem Scaling auf dem Test-Time Compute. Das Scaling at Test-Time bedeutet, wenn man anthropomorphisch argumentiert, dass das Modell sich Zeit nimmt, um nachzudenken, bevor es eine Antwort gibt. Konkreter gesagt, generiert es verborgene Tokens, wo es lange Überlegungen entwickelt, bevor es die endgültige Antwort generiert, die dem Benutzer geliefert wird. Diese Innovation ermöglicht es den Modellen daher, als
denkende Systeme vom Typ II, und nicht vom Typ I.
Noch kürzlicher, am 31. Januar 2025, veröffentlichte OpenAI zwei neue Modelle: o3 und o3-mini. o3-mini hätte eine Leistung von 80% bei AIME 2025, und o3 hätte eine Leistung von 96.7%, womit dieser Benchmark gesättigt wäre!
Das „Scaling at Test-Time“ ist eine neue vielversprechende Forschungsdimension und sollte ab 2025 und darüber hinaus die Entwicklung von AI-Modellen mit immer robusteren und komplexeren Denkweisen ermöglichen. Dazu müssten jedoch neue, anspruchsvollere Benchmarks erstellt werden, um dies zu belegen. Dies ist seit einigen Monaten der Fall, mit FrontierMath.
FrontierMATH
Im November 2024 veröffentlichte das Forschungsinstitut Epoch AI
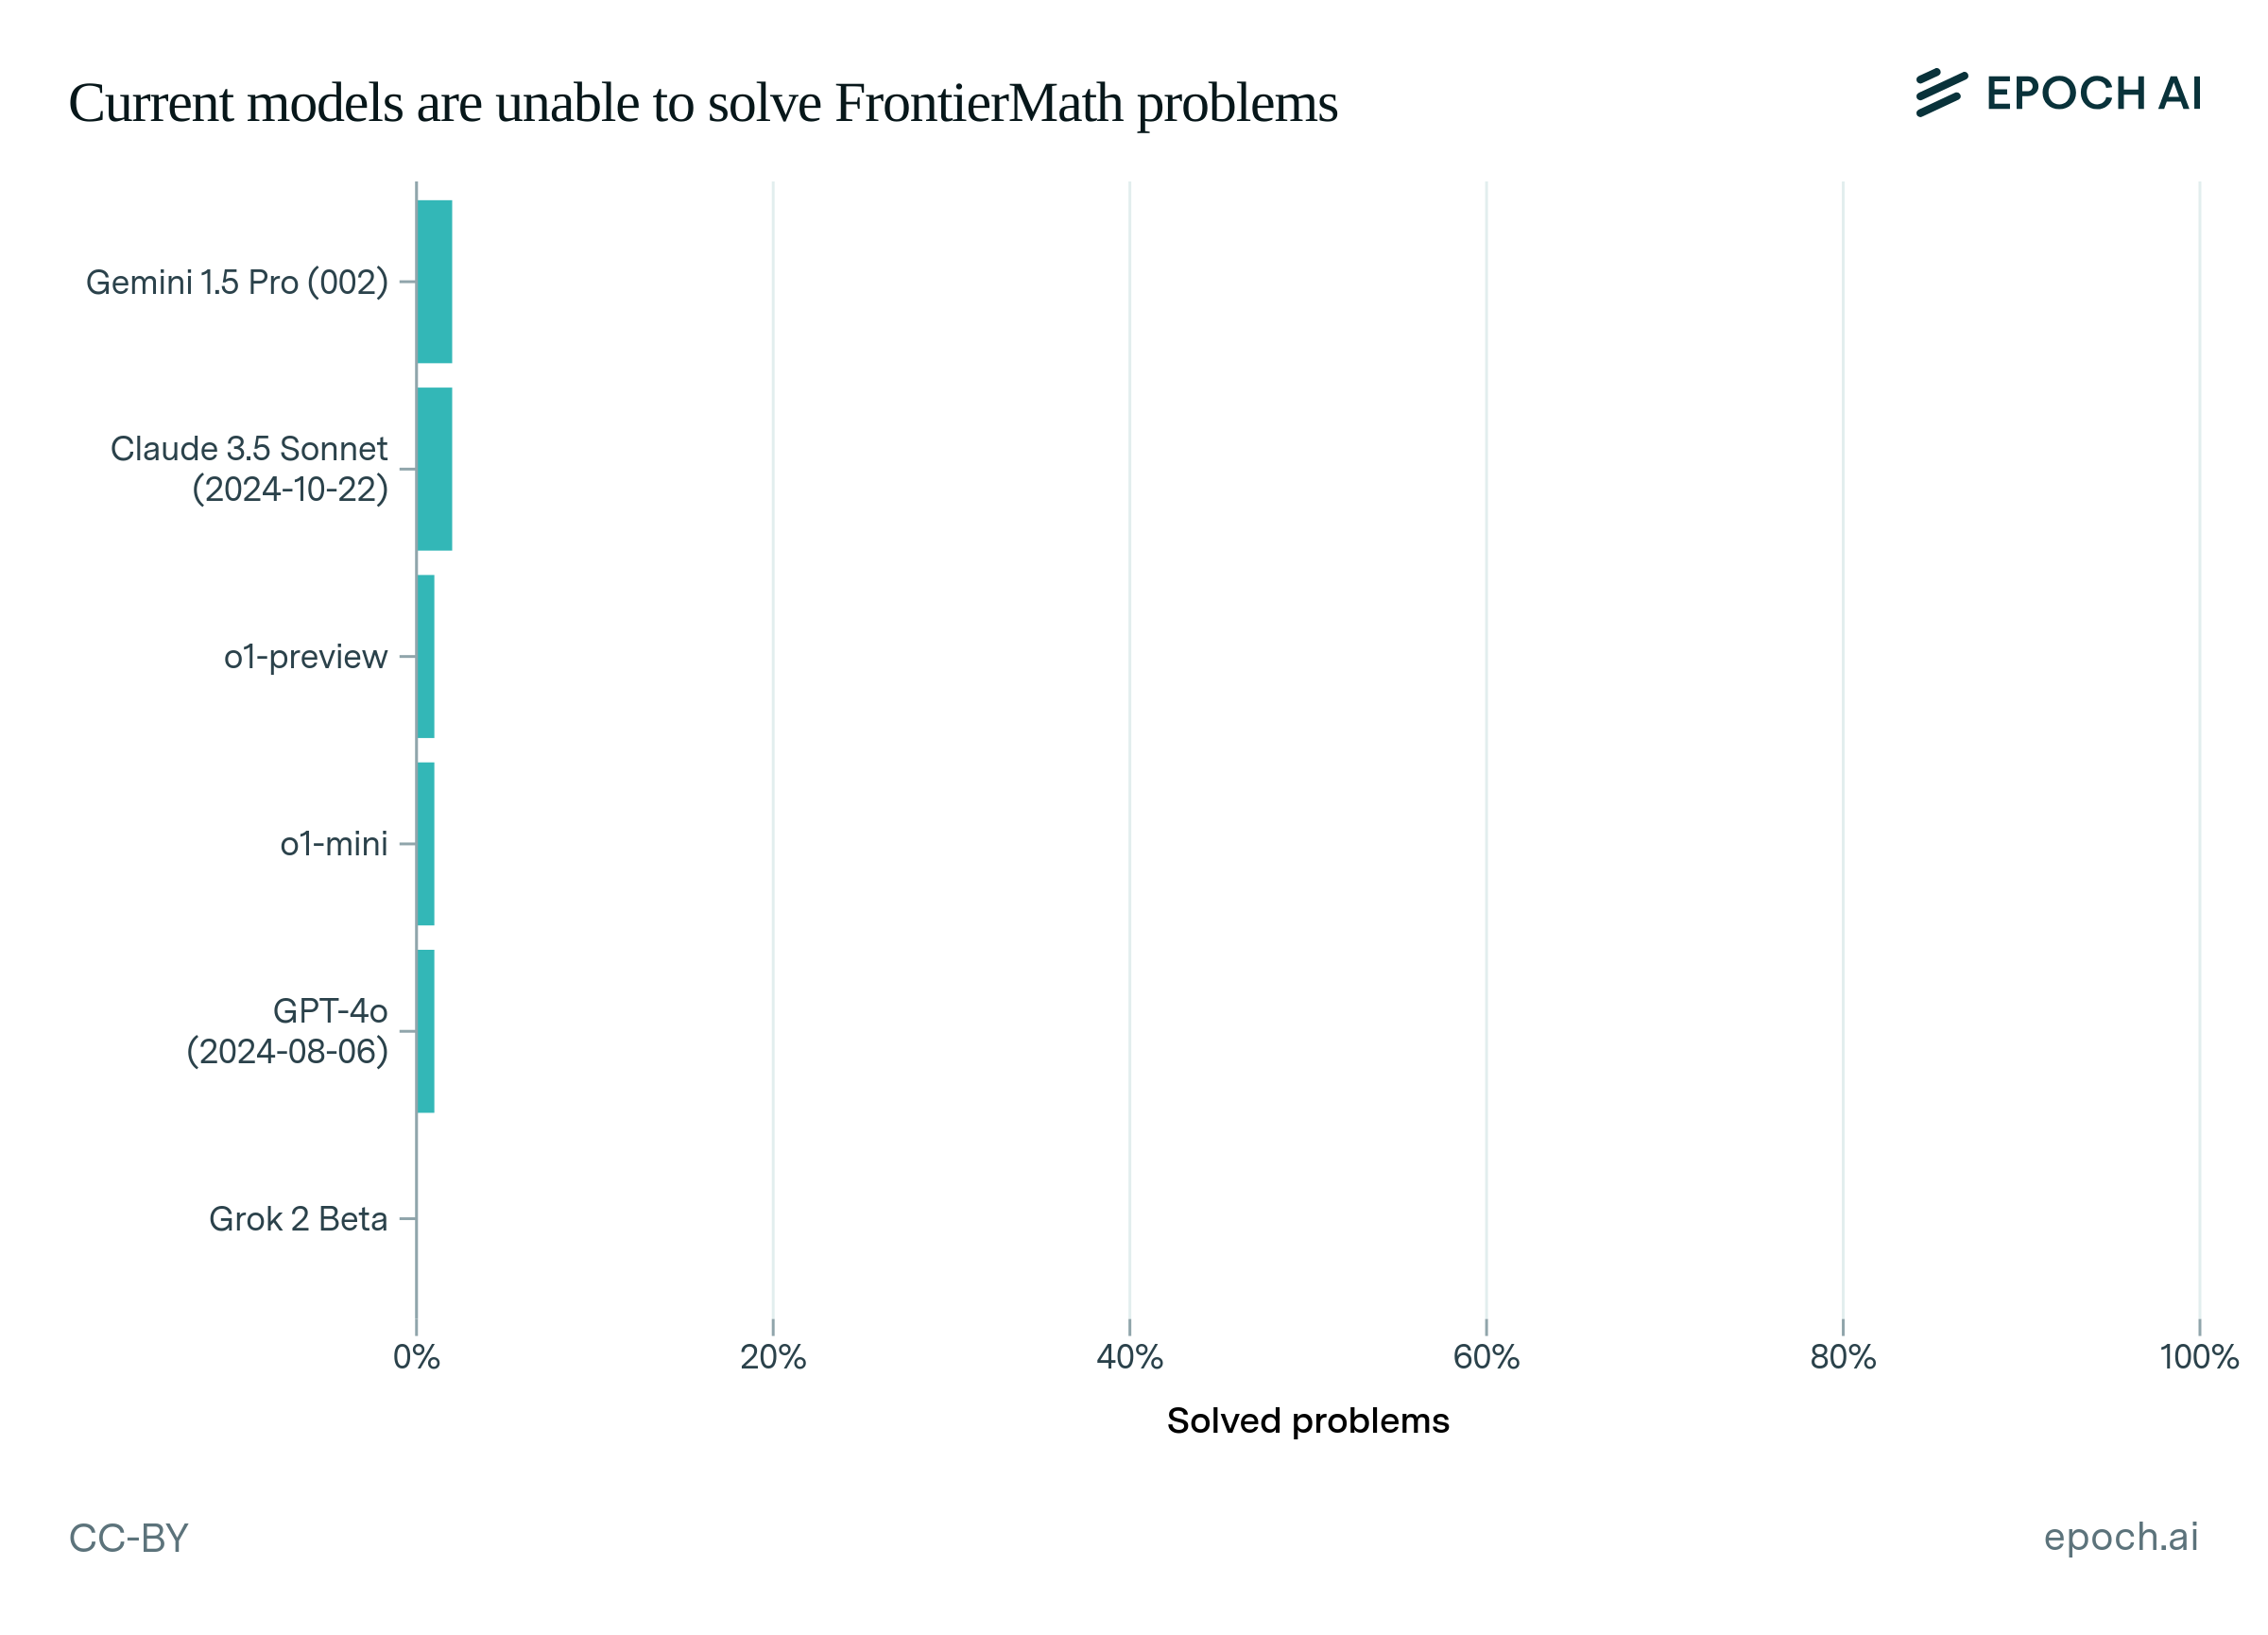
FrontierMath, einen Benchmark, der Hunderte von Expertenproblemen enthält, die die besten AI-Modelle (der damaligen Zeit) nur in 2% der Fälle lösen.
Diese Probleme wurden von etwa sechzig Mathematikern verfasst, darunter Autoren von Olympiadefragen und Fields-Medaillengewinner. Diese Probleme sind bewusst innovativ und unveröffentlicht und zielen darauf ab, das tatsächliche mathematische Verständnis der Modelle zu testen. Sie sind auch „robust“, mit einer Wahrscheinlichkeit von weniger als 1%, die richtige Antwort zufällig zu erraten.
Laut Epoch AI wurden die Modelle unter den bestmöglichen Bedingungen getestet: Eine verlängerte Nachdenkzeit und die Möglichkeit, über eine Python-Umgebung zu experimentieren und zu iterieren, wo sie Code ausführen können, um Hypothesen zu testen und ihre Zwischenergebnisse zu überprüfen. Im November 2024 lösten nur Gemini 1.5 Pro und Claude 3.5 Sonnet mehr als 1% der Probleme. In der Mathematik also ein Sieg für die (besten) Menschen?
Bis heute, ja. Allerdings würde das OpenAI o3-Modell, das kurz nach diesem Benchmark veröffentlicht wurde, eine
Leistung von 25%, was einen rasanten Fortschritt in wenigen Monaten zeigt.
Gemäss dieser
Quelle, würde sich FrontierMath in drei Schwierigkeitsstufen gliedern, wobei Tier 1 in Bezug auf die Schwierigkeit den Internationalen Mathematik-Olympiaden entspricht. o3 wäre demnach in der Lage, die Mehrheit der Probleme dieser Stufe zu lösen, aber nicht darüber hinaus.
Und DeepMind? AlphaGeometry und AlphaProof
Doch zurück zu DeepMind, heute eine Tochtergesellschaft und ein Forschungslabor von Google. Weniger stark in den Medien präsent als OpenAI, sind sie in diesem Innovationsrennen keineswegs im Rückstand. Im Juli 2024 veröffentlichten sie die Modelle
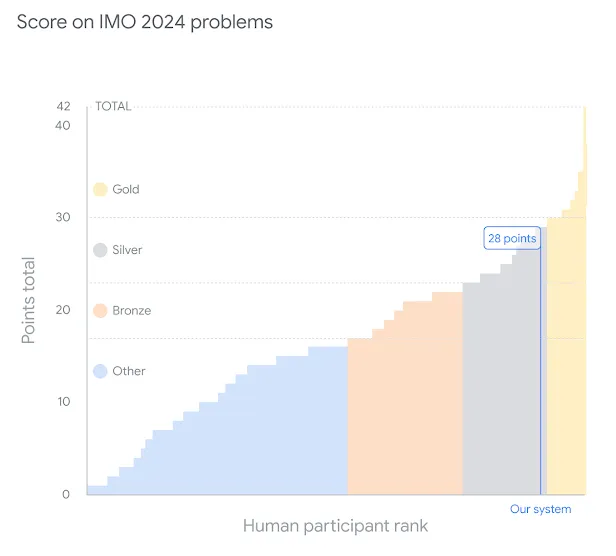
AlphaProof und AlphaGeometry 2, die dem formalen mathematischen Denken gewidmet sind und auf Reinforcement Learning basieren. Diese Modelle lösten 4 der 6 Probleme der Ausgabe 2024 der Internationalen Mathematik-Olympiade, eine Leistung, die den Gewinn einer Silbermedaille bei dieser Ausgabe ermöglichte. Das Äquivalent eines 59. Platzes unter 609 Teilnehmern.
Schliesslich gibt DeepMind an, bei dieser Ausgabe ein auf Gemini basierendes System für natürliches Sprachverständnis getestet zu haben, das es ermöglicht, die präsentierten Probleme nicht in die formale Sprache von AlphaProof und AlphaGeometry 2 übersetzen zu müssen. Die Ergebnisse seien „sehr vielversprechend“. Die Ausgabe 2025 der Olympiade dürfte einige Überraschungen bereithalten.
Und in Zukunft?
Betreffend die Benchmarks sind ebenfalls Innovationen zu erwarten: Epoch AI hat kürzlich angekündigt, an einer
Reihe von Tier 4-Problemen, Probleme, deren Lösung die Zusammenarbeit ganzer Mathematik-Abteilungen erfordern dürfte.
Die Optimistischsten bezüglich der Zukunft der KI sind der Meinung, dass eine Erhöhung des Trainingsdatenvolumens und der bereitgestellten Rechenleistung die Leistung von KI-Modellen logarithmisch (und unbegrenzt) steigern wird, gemäss den
scaling laws. Dieses scaling kann, wie zuvor erwähnt, in verschiedenen Dimensionen erfolgen: dem Pre-training, dem Post-training und, neuerdings, bei den „computations at inference time“.
Im Dezember 2024 hat OpenAI Terence Tao, Fields-Medaillengewinner 2006, zu einer
Konferenz über die Zukunft der Mathematik mit „denkenden“ Modellen. Letzterer ist optimistisch bezüglich des Einsatzes von KI im Allgemeinen in der mathematischen Forschung, wo die Modelle die Rolle von Forschungsassistenten spielen werden, die einen Teil der heute noch vollständig manuellen Aufgaben übernehmen können.
Dieser argumentiert jedoch, dass die Mathematik niemals vollständig von KI gelöst werden wird: „Selbst wenn die KI in der Lage wird, alle Mathematik zu betreiben, die wir heute betreiben, bedeutet das, dass wir einfach zu einer höheren Art von Mathematik übergehen werden.“ Eines ist sicher: KI hat eine wichtige Rolle zu spielen und wird das Tempo der Entdeckungen in diesem Bereich beschleunigen.