2016 - AlphaGo versus Lee Sedol - quando l'AI diventa creativa?
Il 15 marzo 2016, il quinto match di Go tra Lee Sedol, il 2° giocatore più titolato della storia, e
AlphaGo, un programma informatico sviluppato da Deepmind, un'azienda britannica acquisita da Google due anni prima, si concludeva. AlphaGo vinceva la competizione, con 4 vittorie e 1 sconfitta.
Parlando della mossa 37 della seconda partita, Sedol dichiarò: “Pensavo che AlphaGo si basasse su calcoli di probabilità, e che fosse solo una semplice macchina. Ma, quando ho visto questa mossa, ho cambiato idea. Sicuramente, AlphaGo è creativo. Questa mossa era davvero creativa e bella.”
Il gioco del Go è stato a lungo considerato una grande sfida per l'AI: il gioco presenta 10 alla potenza di 170 configurazioni di scacchiera possibili, ovvero 1 googol (10 alla potenza di 100) volte più del gioco degli scacchi. È persino più del
numero di atomi nell'universo conosciuto.
AlphaGo è un sistema AI che combina due reti neurali (Policy Network e Value Network) e algoritmi di ricerca avanzati. L'addestramento di AlphaGo ha tratto vantaggio dal Reinforcement Learning: AlphaGo ha giocato milioni di partite contro se stesso.
Nonostante la sua complessità matematica astronomica, il gioco del Go consiste "semplicemente" in una scacchiera di 19x19 caselle e 361 pedine. Questo universo finito sembra, intuitivamente, più semplice da padroneggiare per una macchina che muoversi e agire nell'universo fisico (robotica), o... la matematica, di cui Banach diceva che rimane "la più bella e la più potente creazione dello spirito umano". Fino ad ora? È quello che cercheremo di scoprire.
Il benchmark MATH
I problemi di MATH coprono 7 argomenti, tra cui la geometria, l'algebra lineare e la teoria dei numeri, e sono classificati in 5 livelli di difficoltà. La performance umana su MATH non è perfetta: un dottorando in informatica avrebbe una performance di circa il 40%, mentre un triplice medagliato d'oro alle Olimpiadi Internazionali di Matematica avrebbe una performance di circa il 90%.
E i modelli di AI? La loro performance varia dal 3.0% al 6.9%, con un massimo del 15% sui problemi più semplici. I modelli testati erano GPT-2 (da 100 milioni di parametri a 1.5 miliardi) e GPT-3 (da 13 a 175 miliardi di parametri), modelli oggi superati.
Nel 2021, gli autori concludevano che, contrariamente a molte altre attività basate sul testo, "scalare" i transformer-based models (che sono il
fondamento dell'AI Generativa) non permette di risolvere il benchmark MATH.
E oggi?
I modelli “o” di OpenAI e il benchmark AIME
Meno di 4 anni dopo, la situazione è alquanto diversa: il
modello o1 di OpenAI, pubblicato a settembre 2024, raggiungerebbe sul benchmark MATH una performance del 94.8%. Questo benchmark è quindi ora considerato saturo. o1 ottiene inoltre una performance dell'83.3% sui problemi della competizione AIME 2024, un benchmark di difficoltà superiore.
AIME (per American Invitational Mathematics Examination) è un dataset che comprende i problemi della competizione omonima, in corso dal 1983. È un esame di 3 ore con 15 domande, destinato ai migliori studenti liceali americani in matematica. I problemi associati sono complessi, richiedono approcci creativi e hanno tutti come soluzione un numero intero compreso tra 0 e 999.
I modelli di OpenAI della famiglia "o" sono i primi della loro categoria, con uno scaling sul test-time compute. Lo scaling at test-time significa, se si ragiona in modo antropomorfico, che il modello si prende il tempo di riflettere prima di dare una risposta. Più concretamente, genera token nascosti, dove sviluppa lunghi ragionamenti, prima di generare la risposta definitiva che sarà fornita all'utente. Questa innovazione permette quindi ai modelli di essere considerati come
sistemi pensanti di tipo II, e non di tipo I.
Ancora più recentemente, il 31 gennaio 2025, OpenAI ha pubblicato due nuovi modelli: o3 e o3-mini. o3-mini avrebbe una performance dell'80% su AIME 2025, e o3 avrebbe una performance del 96.7%, saturando quindi questo benchmark!
Lo “scaling at test-time” è una nuova dimensione di ricerca promettente, e dovrebbe permettere, già dal 2025 e oltre, di sviluppare modelli di AI con ragionamenti sempre più robusti e complessi. Sarebbe comunque necessario, per attestarne la validità, che venissero creati nuovi benchmark più esigenti. Questo è il caso da alcuni mesi, con FrontierMath.
FrontierMATH
A novembre 2024, l'istituto di ricerca Epoch AI pubblicava
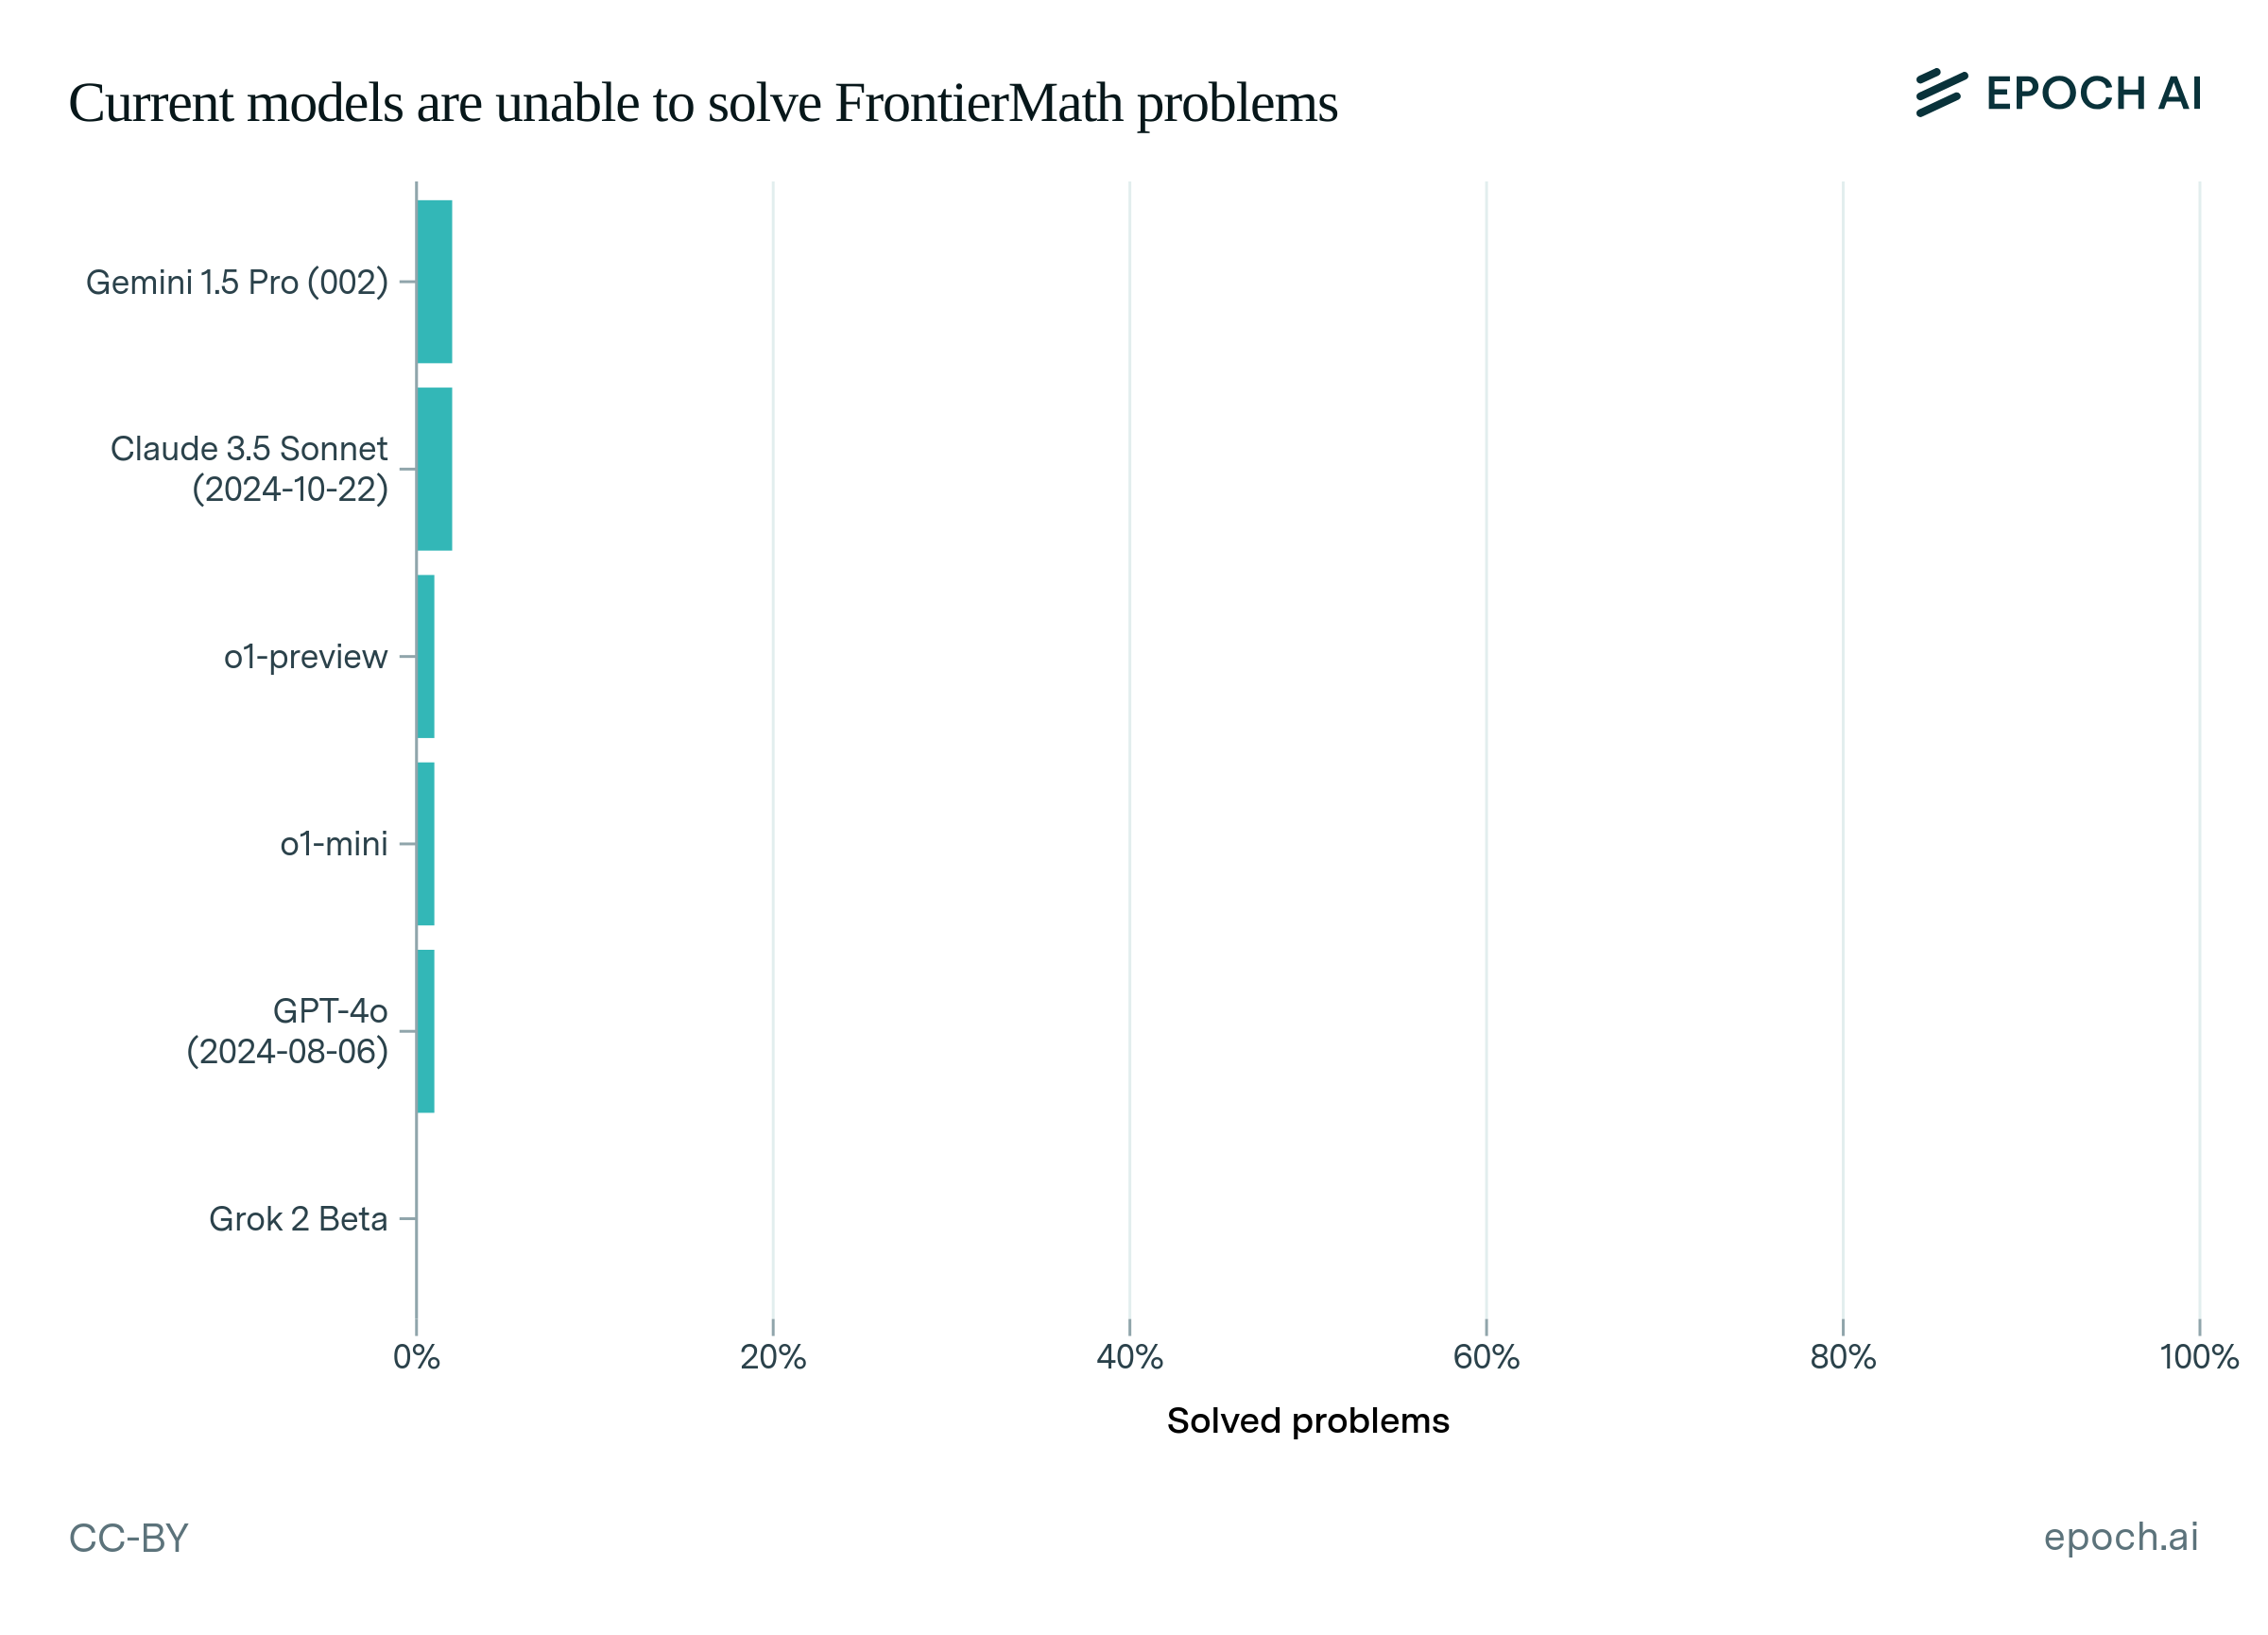
FrontierMath, un benchmark contenente centinaia di problemi esperti, che i migliori modelli di AI (dell'epoca) risolvevano solo nel 2% dei casi.
Questi problemi sono stati redatti da una sessantina di matematici, inclusi redattori di domande delle Olimpiadi e medagliati Fields. Volontariamente innovativi e non pubblicati, questi problemi mirano a testare la reale comprensione matematica dei modelli. Sono anche "robusti", con una probabilità inferiore all'1% di indovinare a caso la risposta corretta.
Secondo Epoch AI, i modelli sono stati testati nelle condizioni più favorevoli possibili: un tempo di riflessione esteso, e la possibilità di sperimentare e iterare tramite un ambiente Python dove possono eseguire codice per testare ipotesi e verificare i loro risultati intermedi. A novembre 2024, solo Gemini 1.5 Pro e Claude 3.5 Sonnet risolvevano più dell'1% dei problemi. In matematica, vittoria per i (migliori) umani, quindi?
Ad oggi, sì. Tuttavia, il modello o3 di OpenAI, pubblicato poco tempo dopo questo benchmark, otterrebbe una
performance del 25%, indicando un progresso fulmineo in pochi mesi.
Secondo questa
source, FrontierMath si scomporebbe in tre livelli di problemi, il Tier 1 corrispondente in difficoltà alle Olimpiadi Internazionali di Matematica. o3 sarebbe quindi in grado di risolvere la maggior parte dei problemi di questo livello, ma non oltre.
E DeepMind? AlphaGeometry e AlphaProof
Ma torniamo a DeepMind, oggi una filiale e un laboratorio di ricerca di Google. Meno pubblicizzati di OpenAI, questi ultimi non sono da meno in questa corsa all'innovazione. Nel luglio 2024, pubblicavano i modelli
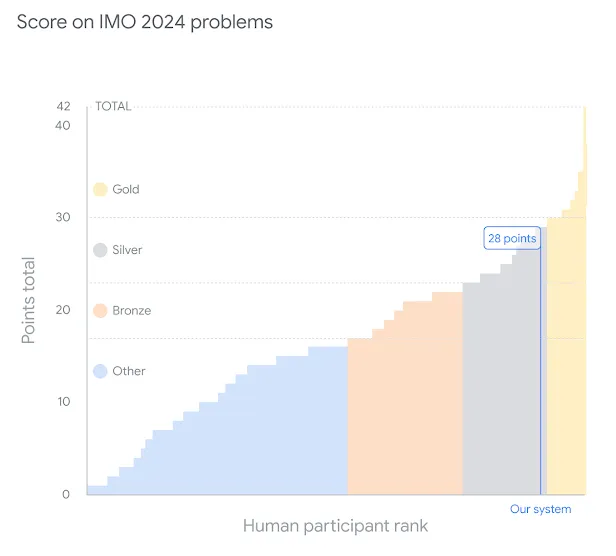
AlphaProof e AlphaGeometry 2, dedicati al ragionamento matematico formale e basati sul Reinforcement Learning. Questi modelli hanno risolto 4 dei 6 problemi dell'edizione 2024 delle Olimpiadi Internazionali di matematica, una performance che ha permesso di ottenere una medaglia d'argento in questa edizione. L'equivalente di un 59° posto su 609 partecipanti.
Infine, DeepMind dichiara di aver testato, in questa edizione, un sistema di ragionamento in linguaggio naturale, basato su Gemini, e che permette di non dover tradurre i problemi presentati nel linguaggio formale proprio di AlphaProof e AlphaGeometry 2. I risultati sarebbero “molto promettenti”. L'edizione 2025 delle Olimpiadi dovrebbe riservare il suo carico di sorprese.
E in futuro?
Per quanto riguarda i benchmark, sono attese anche innovazioni: Epoch AI ha recentemente annunciato di lavorare su una
serie di problemi di Tier 4, problemi che dovrebbero richiedere la collaborazione di interi dipartimenti di matematica per essere risolti.
I più ottimisti sul futuro dell'IA sostengono che aumentare il volume di dati di addestramento e la potenza di calcolo fornita permetterà di aumentare in modo logaritmico (e indefinito) le prestazioni dei modelli di IA, secondo le
scaling laws. Questo scaling può avvenire su diverse dimensioni, come visto in precedenza: il pre-training, il post-training, e, più recentemente, sulle “computations at inference time”.
Nel dicembre 2024, OpenAI ha invitato Terence Tao, medaglia Fields 2006, a una
conferenza sul futuro della matematica con i modelli “a ragionamento”. Quest'ultimo è ottimista sull'uso dell'IA in generale nella ricerca in matematica, dove i modelli giocheranno il ruolo di assistenti di ricerca, capaci di realizzare una parte dei compiti oggi interamente manuali.
Tuttavia, quest'ultimo sostiene che la matematica non sarà mai interamente risolta dall'IA: "Anche se l'IA diventasse capace di fare tutta la matematica che facciamo oggi, ciò significa che passeremo semplicemente a un tipo superiore di matematica". Una cosa è certa, l'IA ha un ruolo importante da svolgere e permetterà di accelerare il ritmo delle scoperte in questo campo.