Cos'è GraphQL? O piuttosto, iniziamo dalla domanda: cosa non è GraphQL? Nonostante il suo nome, GraphQL non è un database alternativo a MySQL né un linguaggio concorrente a SQL. Infatti, GraphQL è un linguaggio di query per API. Se facciamo una breve storia dei diversi modi di inviare e ricevere dati nel tempo, possiamo distinguere tre fasi: l'età della pietra, l'età del bronzo e l'età del ferro.
Nella nostra piccola analogia, l'età della pietra corrisponde al protocollo SOAP. Concretamente, le API SOAP inviano dati in formato XML, generalmente utilizzando il protocollo HTTP (ma non necessariamente). Il vero problema con SOAP è l'aspetto prolisso delle richieste; il formato è pesante e inadatto per le problematiche attuali. È stato necessario trovare una soluzione passando all'età del bronzo, l'API REST. In questo caso, REST non è un protocollo (a differenza di SOAP) ma piuttosto un insieme di regole e vincoli da utilizzare per stabilire un minimo di coerenza e interoperabilità su internet. REST utilizza esclusivamente il protocollo HTTP e generalmente comunica tramite un formato JSON. Come il Signor Jourdain nel Borghese gentiluomo che faceva prosa senza saperlo, molti hanno alla fine fatto REST senza saperlo, implementando un semplice server Node.js per esempio. Lo svantaggio principale di REST è anche il suo principale vantaggio, la sua malleabilità. Non c'è un vero standard seguito da tutti e può trasformarsi rapidamente in un far west! Abbiamo quindi dovuto evolvere verso l'età del ferro. L'età del ferro è GraphQL.
Non passeremo troppo tempo sulla teoria, ma è importante capire che, a differenza degli altri, GraphQL è un linguaggio; è un modo semplice ed elegante di fare richieste al server. GraphQL utilizza il metodo POST del protocollo HTTP e, a differenza di REST, utilizza una sola rotta. GraphQL ha bisogno solo di un endpoint. Per capire meglio tutto questo, faremo un piccolo sito con REST da un lato e vedremo come potremmo adattarlo con GraphQL.
Il nostro sito si interesserà al misterioso popolo dei Galadhrim, un popolo di elfi del Signore degli Anelli. Questo popolo vive nella foresta e costruisce capanne sugli alberi come case. Nel nostro mondo, ogni elfo potrà anche avere amici e una casa. Se vogliamo costruire un database a partire da queste informazioni, ci servirebbe:
elfi : elfeId (Int), name (String), age (Int), houseId (Int)
case : houseId (Int), surface (float), woodType (enum)
amici : friendId (Int), firstElfeId (Int), secondElfeId (Int)
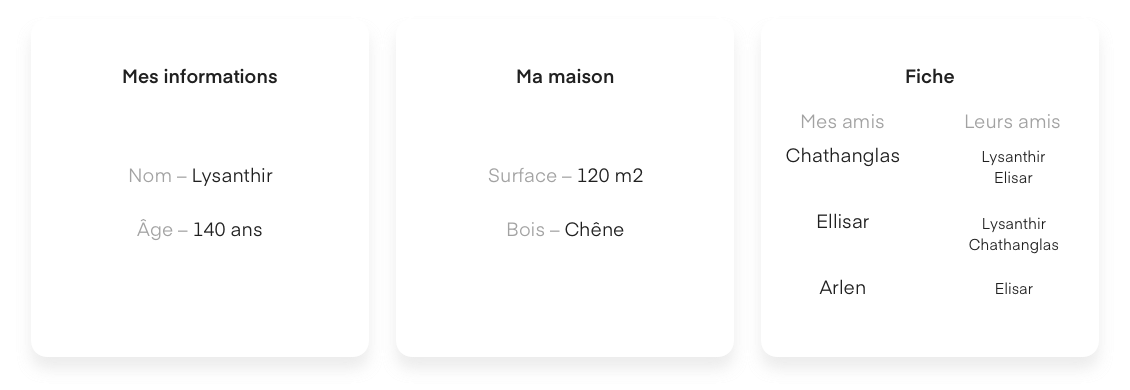
Ecco come dovrebbe apparire la nostra pagina:
Possiamo distinguere 4 parti:
Le mie informazioni personali
La superficie della nostra casa e il tipo di legno utilizzato
La lista dei miei amici
La lista degli amici dei miei amici
Con REST
Tecnicamente, utilizzando un'API REST, dovremmo effettuare le seguenti chiamate:
GET /elfe pour récupérer les données de mon elfe
GET /house pour récupérer les données de ma maison
GET /friends pour récupérer l’ensemble de mes amis
GET /friends?elfeIds=[1,4,8] pour récupérer les amis de mes amis
Potremmo tecnicamente fare tutte queste richieste in una sola volta, ma ciò sarebbe specifico per questa pagina e la nostra intera API diventerebbe caso per caso. Il che non è davvero una buona pratica, perché ciò complicherebbe notevolmente la leggibilità del codice e la comprensione dell'API per uno sviluppatore, che avrebbe a che fare con una moltitudine di endpoint specifici. Inoltre, per preservare l'architettura più pulita e semplice, è senza dubbio più logico fare 4 chiamate API consecutive.
Con GraphQL
Con GraphQL, c'è una sola chiamata:
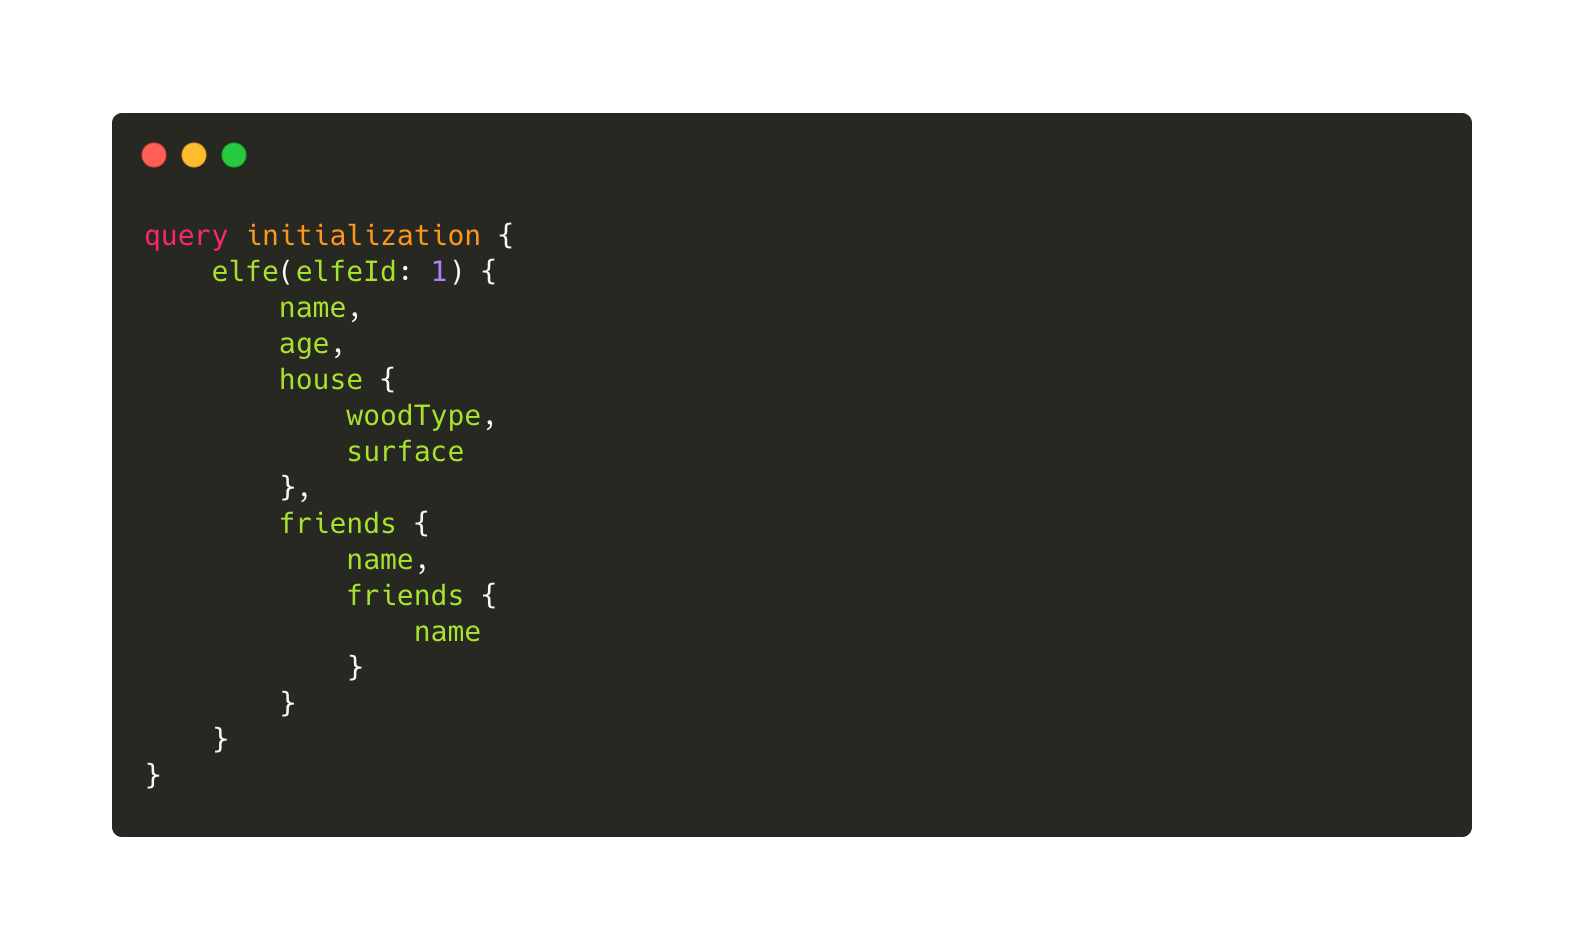
Infatti, GraphQL è un linguaggio e quindi tutta la sottigliezza risiede nel contenuto (body) inviato nella richiesta. Questo contenuto segue un formato particolare ed è interpretato dal nostro back-end. Ecco come si presenta il nostro body:
Cerchiamo di analizzare il contenuto:
La parola query si riferisce al tipo di richiesta che si fa a GraphQL; se ne distinguono due, i tipi query e i tipi mutation. Una query richiede dati al server, una mutation effettua una modifica, ad esempio un'inserzione in database. Qui, richiediamo informazioni, quindi facciamo una richiesta di tipo query. C'è anche un altro tipo, chiamato subscription, ma non lo usiamo qui.
La parola initialization non è molto importante, è il nome che ho dato alla mia query; avresti potuto mettere qualsiasi cosa, legolas per esempio, e avrebbe funzionato!
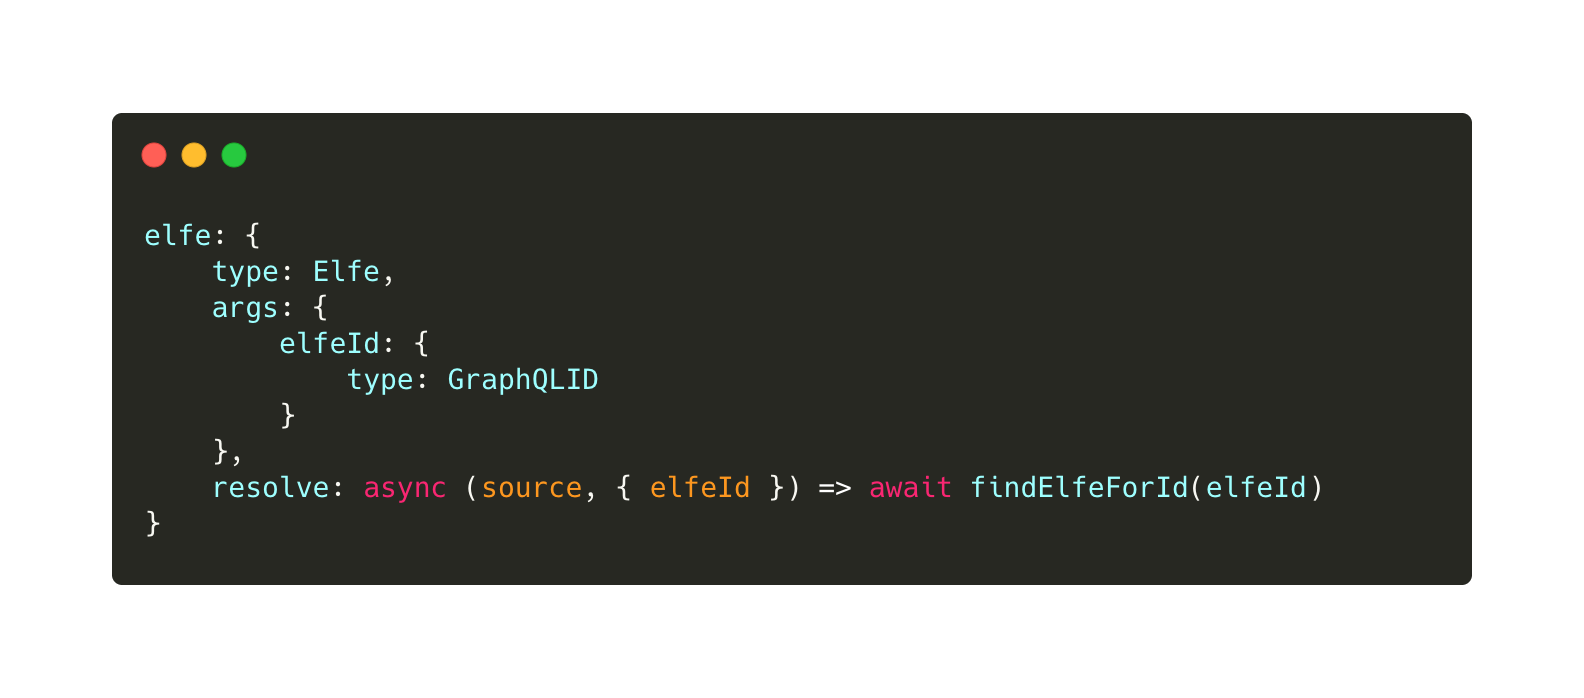
La parola elfo, invece, è importante; si riferisce alla query che userò. Mi spiego: quando creo la mia API GraphQL, dovrò scrivergli una rappresentazione del mio database affinché possa comprendere gli attributi di ciascuno, i collegamenti, ecc. La mia query assomiglierà a questo:
Gli chiederemo quindi di restituirmi un elfo per un identificatore elfeId passato come parametro (nel nostro caso, elfeId vale 1). Usiamo poi un resolver che andrà a cercare le mie informazioni. Per farla semplice, un resolver è una funzione che cerca dati nel database tramite una query SQL per esempio.
Il tipo Elfe che definiamo nella nostra query possiede quindi tutti gli attributi di cui abbiamo bisogno: un nome, un'età, una casa e amici. Il resolver getElfeForId userà quindi altre funzioni per andare a cercare nel database ciò di cui abbiamo bisogno.
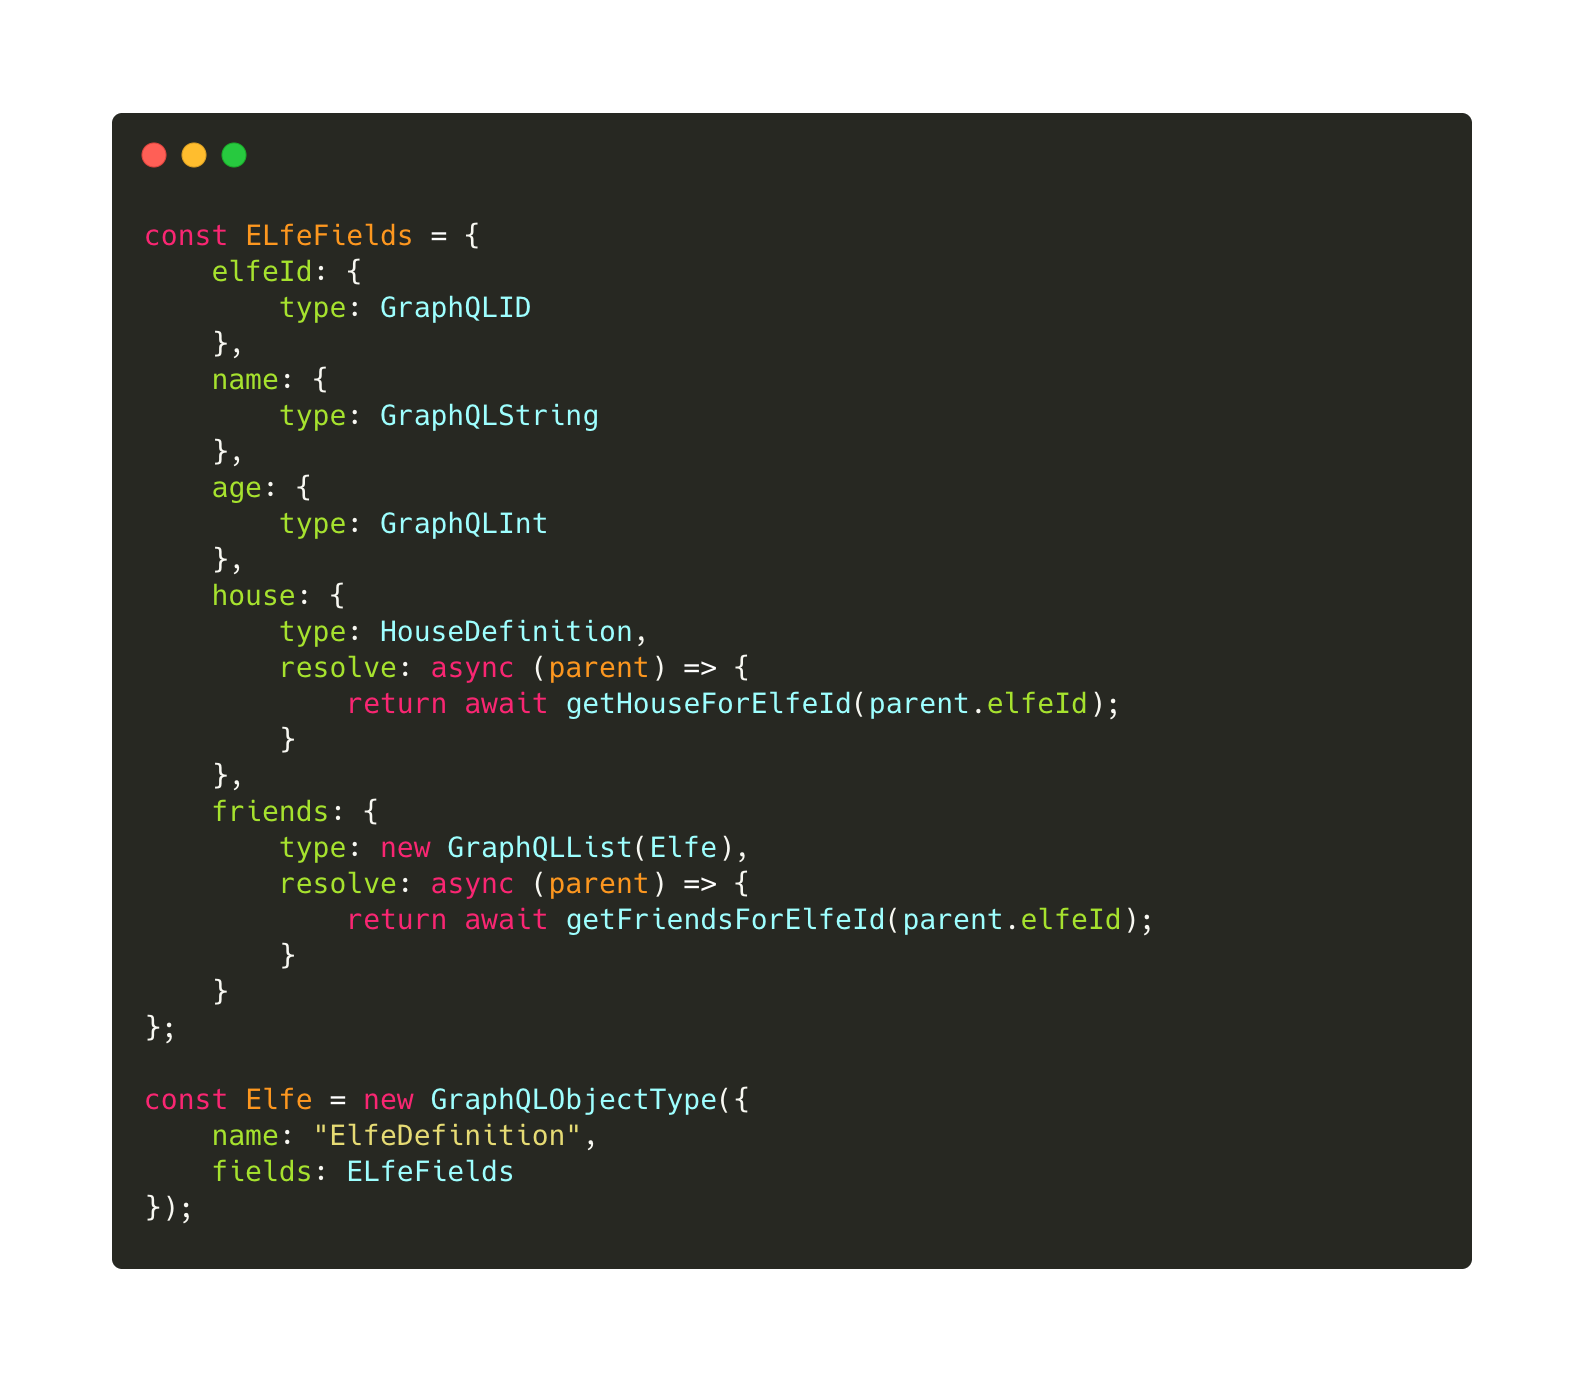
Il tipo Elfe di cui parliamo è definito così a livello di back-end:
È importante capire qui che non c'è magia a questo livello, bisogna esplicitamente fare delle query SQL per poi produrre l'oggetto Elfe che ci aspettiamo. Così, le funzioni getHouseForElfeId e getFriendsForElfeId sono alla fine delle query SQL. In GraphQL, i campi (fields) hanno dei tipi; questi tipi possono essere primitivi come degli interi (GraphQLInt) o dei tipi generati come il tipo Elfe. Così, si può restituire un oggetto o una lista di oggetti (utilizzando GraphQLList) come campo. Inoltre, con la definizione dell'oggetto Elfe che facciamo qui sopra, il campo friends si aspetta di restituire una lista di elfi!
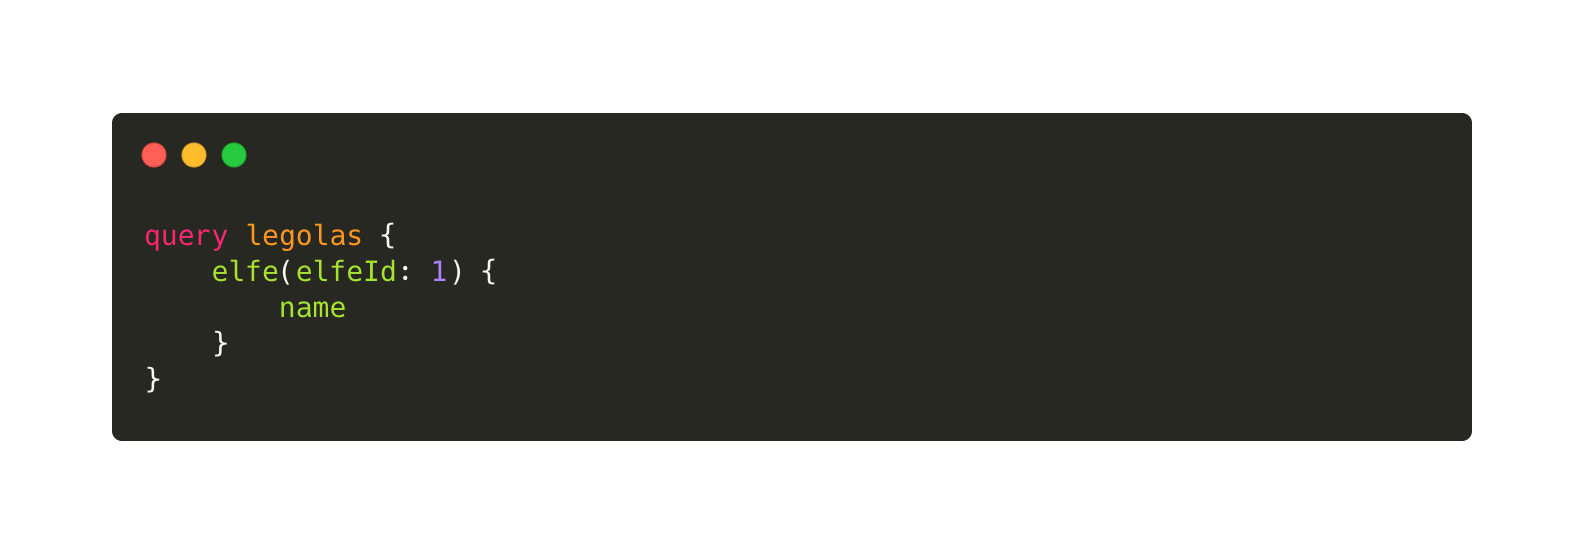
C'è quindi molto lavoro da fare a monte, ma una volta fatto, non c'è più bisogno di toccare il back-end, né di creare nuove rotte, ecc.! Tutto si svolge poi con il front-end, che può chiedere alla nostra API ciò di cui ha bisogno. Se in una pagina abbiamo bisogno solo del nome dell'elfo per esempio, la nostra richiesta assomiglierà a questo:
Nessun lavoro è da fare nel back-end, tutto è già pronto. Possiamo quindi fare una lista della spesa di tutto ciò di cui abbiamo bisogno al momento giusto!
Ecco l'essenza di GraphQL in poche righe. È importante sottolineare che GraphQL porta uno standard e una facilità d'uso non trascurabili. Oltre all'aspetto pratico, la gestione degli errori di GraphQL rende la sua implementazione semplice, se qualcosa non va, GraphQL ce lo dirà rapidamente! Alcuni si chiederanno forse come gestire i diritti di lettura e di modifica, per questo bisognerà usare la nozione di context ! Molti aspetti di GraphQL possono essere approfonditi (e forse lo saranno in un futuro articolo?) ma l'idea di questo articolo è di presentare il bisogno e la risposta offerta da GraphQL.